前言
系列第 3 篇架好 Prometheus + Grafana 之後,「MySQL 備份超過 26 小時沒成功」已經會送到 Slack。但那條告警只要不響,頂多代表備份腳本有跑完,不代表這份備份還原得回來。
【系列】自架 VM 維運實戰 第 6 篇/共 7 篇
上一篇:【效能】k6 壓測 Laravel Octane:找出 2 核 VM 的真實上限
下一篇:【AI】讓 AI 安全查 Grafana:自架官方 mcp-grafana 的五層防護
這篇把整套 MySQL 每日備份從頭講一次,目標有三個:
- 每天自動備份並送離這台主機:本機留 7 天方便快速還原,雲端留 30 天,防這台 VM 壞掉。
- 主機只能上傳、不能刪除:VM 被入侵時,攻擊者沒辦法直接刪掉雲端備份(但不等於一定救得回來,見限制一節)。
- 證明還原得回來:把雲端的備份拉回來,還原到斷網的臨時容器,逐表比對筆數。
環境延續整個系列:一台 2 核 / 12 GB 的 ARM VM,MySQL 8.0 跑在 Docker 裡,上面有三個服務各自的資料庫,文中稱為 app_a、app_b、app_c,原始大小合計約 420 MB,全部是 InnoDB。
先說清楚雲端的部分。我實際用的是 OCI Object Storage,但正文一律用 AWS S3 示範。S3 的寫法依 AWS 與 rclone 官方文件整理,我沒有在 AWS 上實跑。還原演練、監控、耗時的數字都是在 OCI 環境實測的,跟雲端廠商無關。文末附 OCI 對照。
整體架構
整條流程只有一支 bash 腳本加一個 systemd timer:
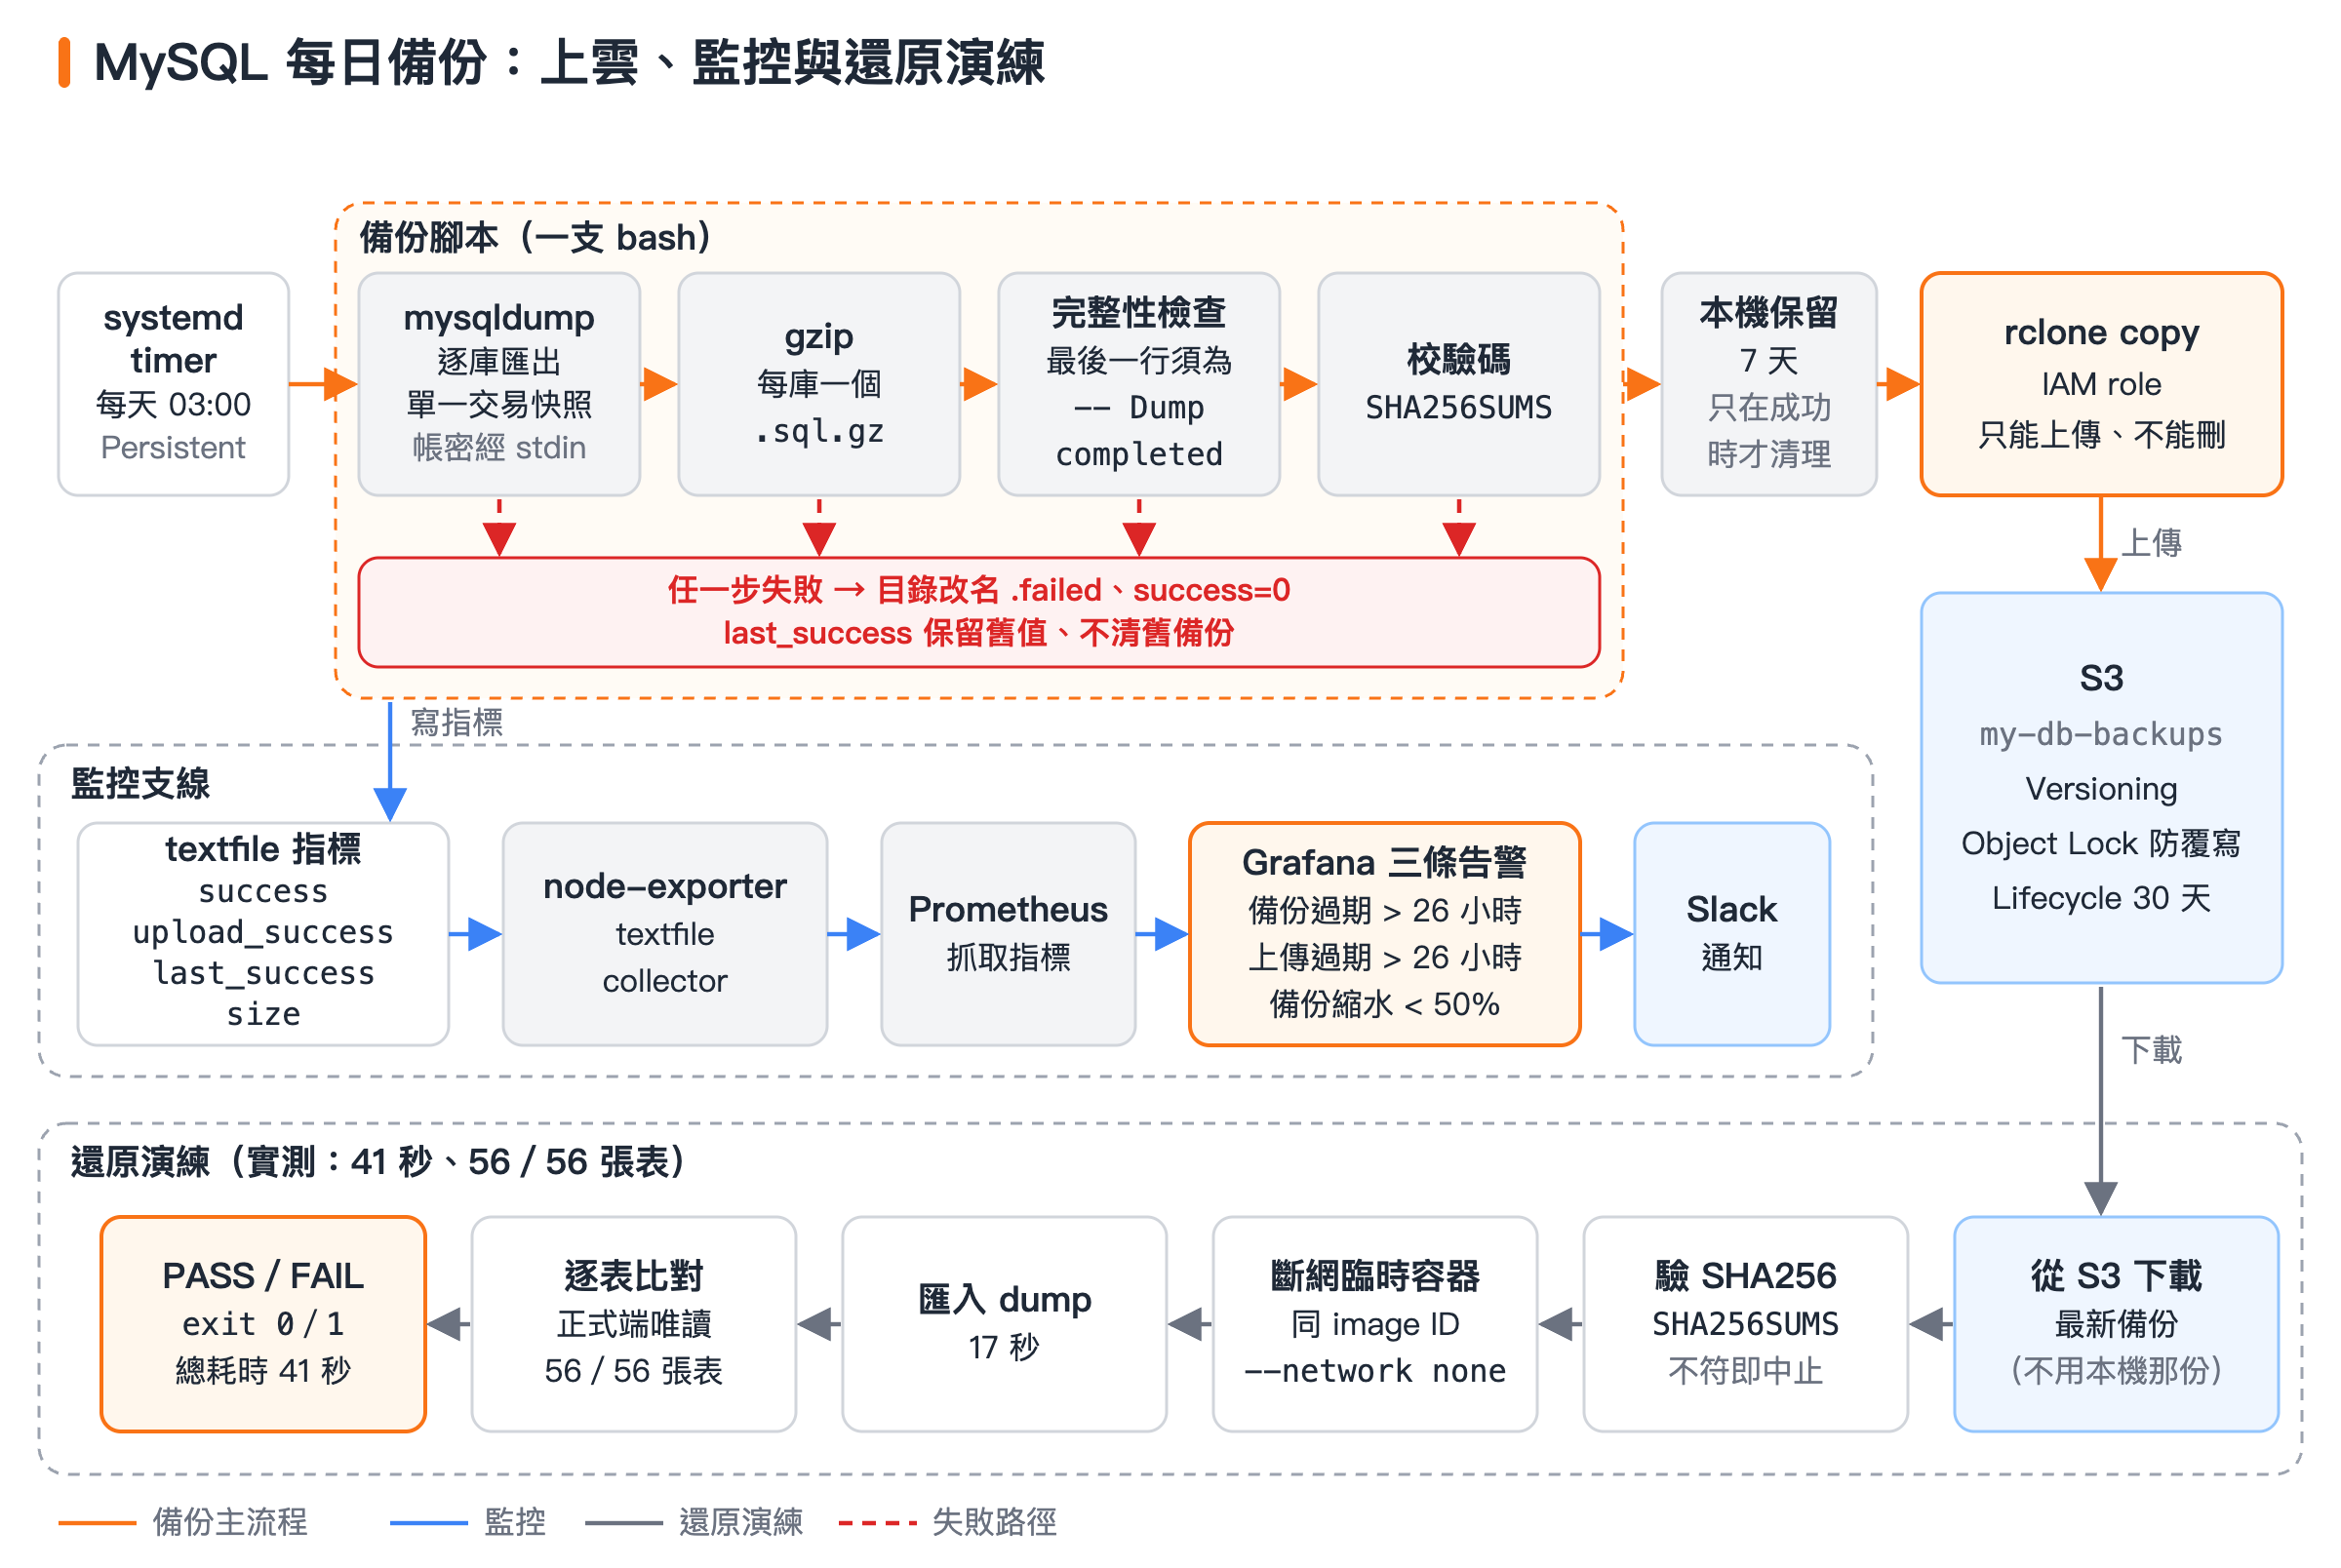
每日備份從匯出到上傳 S3,由三條告警監控,再用斷網容器實測還原。
| 步驟 | 做什麼 | 為什麼 |
|---|---|---|
| 1. 排程 | systemd timer,每天台北 03:00,Persistent=true |
離峰時段;VM 時區是 GMT,所以時區直接寫在 OnCalendar 裡 |
| 2. 匯出 | 逐庫 mysqldump --single-transaction,用唯讀的 backup 帳號 |
全 InnoDB,不鎖表 |
| 3. 壓縮 | gzip -6,每庫一個 .sql.gz |
單庫還原容易 |
| 4. 完整性檢查 | 最後一行必須是 -- Dump completed |
抓出被截斷的匯出 |
| 5. 校驗碼 | 產生 SHA256SUMS |
下載回來時能驗證檔案沒壞 |
| 6. 本機保留 | /var/backups/mysql/<UTC 時間戳>/,保留 7 天 |
誤刪資料時最快拿來還原 |
| 7. 上傳 | rclone copy 到 S3,保留 30 天 |
離開這台主機(同一區、同一個雲端帳號);主機只有上傳權限 |
| 8. 指標 | 寫 node-exporter textfile mysql_backup.prom |
讓 Prometheus 知道備份的結果 |
| 9. 告警 | 三條 Grafana 規則,送 Slack | 沒成功、沒上傳、檔案縮水都會響 |
實際規模:10/16 03:00 的備份,app_a 5.3 MB、app_b 128 KB、app_c 552 KB,每天一個目錄約 6 MB,從開始匯出到上傳完成 3 秒。
為什麼選 mysqldump:這個規模下它夠用,不必額外裝工具,還原只要 zcat | mysql,出事時不容易做錯。這是我自己的取捨。
systemd service 與 timer
# /etc/systemd/system/mysql-backup.service
[Unit]
Description=MySQL daily backup

[Service]
Type=oneshot
ExecStart=/usr/local/sbin/mysql-backup.sh

# /etc/systemd/system/mysql-backup.timer
[Timer]
OnCalendar=*-*-* 03:00:00 Asia/Taipei
Persistent=true

[Install]
WantedBy=timers.target
OnCalendar 直接寫 Asia/Taipei,因為 VM 時區是 GMT,不寫的話會在台北早上 11 點跑。Persistent=true 讓關機時錯過的排程在開機後補跑。備份目錄名用 UTC(date -u),例如 20260101T190000Z 其實是台北 1/2 03:00。
我踩過一個很丟臉的坑:建好 timer 只做了 daemon-reload,忘了 enable,當天稍晚才發現排程根本沒開(那段時間都有手動備份,沒有漏)。建完一定要看一眼下一次執行時間:
sudo systemctl daemon-reload
sudo systemctl enable --now mysql-backup.timer
# 一定要看到 NEXT 欄位有時間,才代表排程真的開了
systemctl list-timers mysql-backup.timer
備份腳本逐段解說
完整腳本(去識別化、已含下一節的修正)放在文末附錄,這裡只拆重點。
mysqldump 的旗標
--single-transaction:用一致性快照讀資料,不鎖表。前提是表都是 InnoDB(我盤點過)。官方文件提醒,匯出期間如果有ALTER、DROP、TRUNCATE這類 DDL,結果可能不一致。--routines --triggers --events:把 stored routine、trigger、event 一起匯出。--set-gtid-purged=OFF:輸出不帶SET @@GLOBAL.GTID_PURGED,還原到另一台(例如演練的臨時容器)比較單純。--databases "$db":一次一個庫,還原時zcat | mysql就會回到同名資料庫。--quick逐列輸出、不把整張表載入記憶體(預設的--opt已包含,寫出來只是明示);--hex-blob把 BINARY/BLOB 欄位用十六進位輸出,避免字元集轉換弄壞二進位資料。
要備份哪些庫,是從 information_schema.schemata 撈出來、排除 mysql、sys、performance_schema、information_schema 四個系統庫,再逐庫匯出。新增服務的資料庫不用改腳本;代價是帳號與權限不在備份內。
完整性檢查:Dump completed
mysqldump 正常結束時,最後一行是 -- Dump completed on ...;中途磁碟滿了或連線斷了,檔案會被截斷,最後一行就不是它。所以腳本在 gzip 之後立刻 zcat | tail -n 1 | grep -q '^-- Dump completed'。整串寫在 if 條件裡:set -e 在 if 條件中不作用,但 pipefail 仍決定整條管線的結束碼,所以 mysqldump、gzip、zcat 任一段失敗都會被 if 接住,這個庫就算 FAIL。
只有全部庫都成功(ok=1)才會上傳。我寧可雲端少一天,也不要上傳一份不完整的備份,然後在 30 天後讓它成為唯一的備份。
帳密經 stdin 傳入容器,不落地
# /etc/mysql-backup.cnf(root:root 600)
[client]
user=backup
password=********
傳進容器的方式是 --defaults-extra-file=/dev/stdin ... < "$MYCNF"(必須是第一個選項):密碼走標準輸入,不會出現在 ps 看得到的命令列,也不會寫進容器的檔案系統。最早的版本是用 root、讀容器環境變數 $MYSQL_ROOT_PASSWORD,每次換 root 密碼都得記得重建容器;改成專用的 backup 帳號後就沒有這個問題。
本機保留 7 天
-mtime +$((LOCAL_KEEP_DAYS - 1)) 用 6 而不是 7:-mtime +6 代表超過 6 個完整天,也就是滿 7 天的目錄才刪。備份根目錄 chmod 700,因為備份檔就是一份完整的資料庫。清理只在這次成功時才做,原因見下一節。
textfile 指標:原子寫入、成功時間只在成功時更新
結果寫成 Prometheus 文字格式,交給 node-exporter 的 textfile collector(系列第 3 篇有介紹)。節錄:
mysql_backup_success 1
mysql_backup_duration_seconds 3
mysql_backup_upload_success 1
mysql_backup_size_bytes{db="app_a"} 5544969
mysql_backup_size_bytes{db="app_b"} 130601
mysql_backup_size_bytes{db="app_c"} 562118
mysql_backup_last_success_timestamp_seconds <這次成功的 unix 秒>
mysql_backup_upload_last_success_timestamp_seconds <這次上傳成功的 unix 秒>- mktemp + mv 原子寫入:先寫到同目錄的暫存檔
.mysql_backup.XXXX,寫完才mv,node-exporter 永遠不會讀到寫一半的檔案;暫存檔以.開頭、不以.prom結尾,不會被誤讀。 - 「最後成功時間」只在成功時更新:失敗時沿用上一次成功的值,
time() - last_success才會一直變大、最後觸發告警。
腳本裡另外順手做了慢查詢 log 輪替(主機的 logrotate 被 SELinux 擋、讀不到 Docker volume),跟備份無關,細節見附錄。
審稿時發現自己腳本的 bug
這篇文章送審時,審稿指出我實際在跑的腳本有好幾個問題。我原本以為「失敗時 ok=0、寫指標、exit 1」這條路是通的,實際上:
set -e讓錯誤在寫指標之前就結束:MySQL 連不上時,dbs=$(mysql_q ...)這個指派本身失敗,腳本立刻結束;沒有任何 dump 檔時,sha256sum *.sql.gz也會直接結束。後面那段「找不到資料庫就ok=0」在最需要它的時候根本沒執行,mysql_backup_success停在上一次的 1。- 慢查詢輪替排在寫指標之前:只要它有一步失敗,就算備份與上傳都成功,這次也跑不到寫指標,
last_success不更新,26 小時後會誤報 critical。 - 失敗那天照刪舊備份:連續失敗 7 天,本機的好備份會被刪光。失敗的目錄還留著截斷的 dump 與
SHA256SUMS,看起來像正常備份。 - 上傳失敗時腳本仍然
exit 0。
告警最後還是會響,是靠「最後成功時間只在成功時更新」碰巧接住。修正思路:
- 預期內的失敗(MySQL 連不上、列不出庫、某庫 dump 失敗、沒有 dump、上傳失敗)改成顯式檢查,一律走到寫指標;預期外的失敗用
trap ... EXIT當安全網,補寫success 0。 - 失敗的目錄改名為
<時間戳>.failed(留現場除錯,下次執行時清掉);只有成功時才清理舊備份。 - 慢查詢輪替移到寫完指標之後,失敗只記 log 與另一個指標。它包成函式、放在
if的條件裡呼叫,函式內的set -e會失效,所以每一步都要自己|| return 1,否則cat失敗後還是會去清空原檔。 - 任何一項失敗(含上傳)最後都
exit 1。
# 原版:MySQL 連不上時,這一行讓 set -e 直接結束,後面的 ok=0 與寫指標都不會執行
dbs=$(mysql_q "SELECT schema_name FROM information_schema.schemata WHERE ...")

# 修正版:預期內的失敗改成顯式檢查,走 ok=0 這條路
if ! dbs=$(mysql_q "SELECT schema_name FROM information_schema.schemata WHERE ..."); then
  echo "cannot list databases (MySQL unreachable?)" >&2
  dbs=""
fi
[ -n "$dbs" ] || { echo "no databases found" >&2; ok=0; }

# 預期外的失敗:EXIT trap 當安全網,指標還沒寫就結束時補寫 success 0
on_exit() {
  local rc=$?
  set +e
  if [ "$metrics_done" = 0 ]; then
    ok=0; mark_failed; write_metrics; exit 1
  fi
}
trap on_exit EXIT
驗證方式:把 stub 版的 docker、rclone 放在 PATH 最前面,路徑換成暫存目錄,模擬 MySQL 連不上、某庫缺 Dump completed、上傳失敗、輪替失敗等情境,檢查結束碼、指標、失敗目錄與舊備份。原版在 MySQL 連不上時 success 停在 1、輪替失敗時成功時間沒更新;修正版都正確。修正版在 10/16 部署到正式主機:用 systemctl start 手動觸發一次,3 個庫備份、上傳、指標都正常(4 秒),再用修正版演練腳本實跑一次還原,結果見後面「還原演練」一節。
最小權限第一層:MySQL 的 backup 帳號
備份帳號只能從容器內的 localhost 登入:
CREATE USER 'backup'@'localhost' IDENTIFIED BY '...';
GRANT SELECT, SHOW VIEW, TRIGGER, EVENT, LOCK TABLES, PROCESS ON *.* TO 'backup'@'localhost';
GRANT SHOW_ROUTINE ON *.* TO 'backup'@'localhost';
-- SHOW GRANTS FOR CURRENT_USER() 的實際結果與上面兩行 GRANT 相同
沒有 INSERT、UPDATE、DELETE、任何 DDL,也沒有 RELOAD、REPLICATION 相關權限,因為腳本不做 --flush-logs、也不記錄 binlog 位置。
| 權限 | 對應的旗標或行為 | 說明 |
|---|---|---|
SELECT |
所有匯出 | 讀資料表的最低要求 |
SHOW VIEW |
匯出 view | 沒有它拿不到 view 的定義 |
TRIGGER/EVENT |
--triggers/--events |
匯出 trigger、event 用 |
SHOW_ROUTINE |
--routines |
8.0 的動態權限;已有全域 SELECT,這項可能重複 |
PROCESS |
沒加 --no-tablespaces |
較新的 8.0 版 mysqldump 預設會查 tablespace 資訊 |
LOCK TABLES |
(用不到) | 用了 --single-transaction 就不需要 |
老實說這還不是真正的最小權限:LOCK TABLES 可以收回。另外「唯讀」不等於「不敏感」:全域 SELECT 讀得到 mysql 系統庫(含密碼雜湊),PROCESS 看得到其他連線正在執行的 SQL。改成只對業務庫授權可以收斂,代價是新增資料庫時要記得補 GRANT。上表是依 mysqldump 官方文件整理的,照抄前請對照你的 MySQL 版本。
最小權限第二層:主機只能上傳
這一層管的是「這台主機能對雲端備份做什麼」。原則只有一句:主機可以上傳、可以列出、可以讀回來驗證,但不能刪。否則攻擊者拿下主機後,第一件事就是清掉雲端備份。
主機上不放任何金鑰:IAM role
VM 在 EC2 上的話,最乾淨的做法是建一個 IAM role,透過 instance profile 掛到 instance 上,主機上不放任何 access key(一台 instance 只能掛一個 role)。rclone 的設定(依文件整理):
# /etc/rclone/rclone.conf(依 rclone 文件整理,未在 AWS 實跑)
[s3-backup]
type = s3
provider = AWS
env_auth = true
region = us-east-1
env_auth = true 是從環境或 IAM 取得憑證,只在兩個 key 欄位都留空時生效。rclone 文件沒有 instance profile 的專門範例,這份是我依文件組合的。
主機不在 EC2 上的話,可以用 IAM Roles Anywhere(X.509 憑證換暫時憑證,但要自備 CA,對一台小機器偏重),或專用 IAM user + access key(只給下面同一份 policy,照 AWS 文件的流程輪替;key 外洩就等於上傳權限外洩,更需要下一節的 Versioning 與 Object Lock)。
只能上傳的 IAM policy
掛在 role 上的 policy(bucket 名稱 my-db-backups,依 AWS 與 rclone 文件整理,沒有實跑過):
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "UploadOnly",
      "Effect": "Allow",
      "Action": ["s3:PutObject", "s3:GetObject", "s3:AbortMultipartUpload"],
      "Resource": "arn:aws:s3:::my-db-backups/mysql/*"
    },
    {
      "Sid": "ListForRcloneCompare",
      "Effect": "Allow",
      "Action": "s3:ListBucket",
      "Resource": "arn:aws:s3:::my-db-backups"
    },
    {
      "Sid": "ExplicitDenyDestructive",
      "Effect": "Deny",
      "Action": [
        "s3:DeleteObject",
        "s3:DeleteObjectVersion",
        "s3:PutLifecycleConfiguration",
        "s3:PutBucketPolicy",
        "s3:PutBucketVersioning",
        "s3:PutBucketObjectLockConfiguration",
        "s3:PutObjectRetention",
        "s3:BypassGovernanceRetention"
      ],
      "Resource": [
        "arn:aws:s3:::my-db-backups",
        "arn:aws:s3:::my-db-backups/*"
      ]
    }
  ]
}s3:PutObject:上傳。走 multipart upload 時,建立、上傳分段、完成三步也只需要它(rclone 預設超過 200 MiB 才分段)。s3:AbortMultipartUpload:只清掉「進行中」的分段,刪不了已完成的物件。s3:GetObject:rclone 預設會對上傳的物件發 HEAD 驗證。代價是被入侵的主機能讀回備份;可改用--s3-no-head,但 rclone 文件警告這會提高上傳失敗沒被發現的機率。s3:ListBucket:rclone 上傳前會先檢查目的端(依文件推斷需要它;rclone 官方範例 policy 也有列)。沒有它時,查不存在的物件會回 403 而不是 404。- 明確 Deny:IAM 預設就是拒絕,這段是設計選擇,防日後有人替這個 role 附加更寬的 policy。特別是
s3:PutLifecycleConfiguration:能改 lifecycle(例如改成 1 天過期)就等於間接刪除。 - 沒放
s3:PutObjectAcl:rclone 文件列的 sync 權限清單裡有它,但新 bucket 預設停用 ACL,rclone 這時還會不會送 ACL header,我查不到。如果照抄後上傳出現 AccessDenied,先檢查這一項。
rclone 要配合兩點:用 copy,不要用 sync(sync 會刪目的端,需要 DeleteObject);加 --s3-no-check-bucket,就不需要 CreateBucket 權限。
我在 OCI 做過刪除測試:以主機身分上傳一個 27 bytes 的測試檔,列得出來、讀得到,刪除被拒絕,檔案仍在;連列出帳號內其他 bucket 都不行。副作用是測試檔本身也刪不掉,這反而是設計有效的證據。
「不能刪」不等於「不能破壞」
查文件時我才發現一個漏洞:在 unversioned 或 version-suspended 的 S3 bucket,上傳同名物件就會直接覆寫(AWS conditional writes 文件)。攻擊者不需要 DeleteObject,有 PutObject 就能把每份備份蓋成空檔。手段由弱到強:
| 手段 | 防得住 | 防不住 | 代價 |
|---|---|---|---|
檔名帶時間戳+ rclone --immutable |
自己的腳本誤蓋 | 被入侵的主機 | 幾乎沒有;本文目錄名每次都不同,實際不會撞名,所以腳本沒加 --immutable |
| Versioning | 覆寫、誤刪(舊版保留,刪除只是加 delete marker) | 有 DeleteObjectVersion 權限的人 |
每個版本都計費;開了就回不到 unversioned,只能 suspend;要 lifecycle 清舊版 |
| Object Lock Governance | 保留期內一般使用者的刪除、覆寫 | 有 s3:BypassGovernanceRetention 的人 |
要管好誰有 Bypass;啟用後不能關 Object Lock、不能 suspend versioning |
| Object Lock Compliance | 保留期內任何人(含 root)都不能刪、不能覆寫、不能縮短保留期 | (幾乎沒有) | 設錯無法補救;文件寫唯一提早刪除的方法是刪掉整個 AWS 帳號 |
另一個選項是用 bucket policy 強制 PutObject 帶 If-None-Match: *,但我查不到 rclone 會不會送這個 header。
- Object Lock 必須先開 Versioning,現行文件寫明既有 bucket 也可以啟用。
- Object Lock 保護的是「版本」:同名上傳會建立新版本,鎖住的舊版本不動;不帶 version ID 的刪除會成功,但只是加一個 delete marker,帶 version ID 的永久刪除則回 403。
- 上面的 IAM policy 沒給
s3:PutBucketVersioning,主機沒辦法把版本控制暫停掉。 - Object Lock 的 bucket 對上傳的 header 有額外要求(Content-MD5 或 checksum),rclone 搭配它我沒實測,啟用後請先手動跑一次上傳。
# 以下都用管理者身分執行,不是備份主機的 role(依 AWS 文件整理)

# 只開 Versioning
aws s3api put-bucket-versioning --bucket my-db-backups \
  --versioning-configuration Status=Enabled

# 或:新建 bucket 時就開 Object Lock(會一併開啟 Versioning)
aws s3api create-bucket --bucket my-db-backups --object-lock-enabled-for-bucket

# 設定 bucket 預設保留:Governance 30 天
# (官方範例是 COMPLIANCE 50 天,這裡依同一語法改寫)
aws s3api put-object-lock-configuration --bucket my-db-backups \
  --object-lock-configuration '{ "ObjectLockEnabled": "Enabled", "Rule": { "DefaultRetention": { "Mode": "GOVERNANCE", "Days": 30 }}}'
建議先用 Governance 測試,再考慮 Compliance。非 us-east-1 的區域建 bucket 通常還要加 --create-bucket-configuration LocationConstraint=eu-west-1(換成你的區域),我沒實跑。
Lifecycle 的兩個坑
坑 1:開了 Versioning 之後,「30 天過期」不會真的刪資料。在版本化的 bucket 裡,Expiration 只會替現行版本加一個 delete marker,資料還在、還在計費;要真的清掉,必須另外加 NoncurrentVersionExpiration。以下依 AWS CLI 文件的格式整理(我沒有實際送出過):
{
  "Rules": [
    {
      "ID": "expire-mysql-backups-30d",
      "Status": "Enabled",
      "Filter": { "Prefix": "mysql/" },
      "Expiration": { "Days": 30 },
      "NoncurrentVersionExpiration": { "NoncurrentDays": 7 },
      "AbortIncompleteMultipartUpload": { "DaysAfterInitiation": 7 }
    },
    {
      "ID": "cleanup-expired-delete-markers",
      "Status": "Enabled",
      "Filter": { "Prefix": "mysql/" },
      "Expiration": { "ExpiredObjectDeleteMarker": true }
    }
  ]
}
NoncurrentDays: 7:被覆寫或刪除的舊版本最多再留 7 天,這是「發現被覆寫後還來得及救」的窗口。AbortIncompleteMultipartUpload清掉沒完成的分段上傳,不然會一直計費。- 第二條是選用的:有
Days時 S3 會自動清過期的 delete marker;想在它變成唯一版本時立刻清,才需要這條。ExpiredObjectDeleteMarker不能跟Days寫在同一條規則。 - 加了 Object Lock 的話,保留期沒到的版本刪不掉,依文件推斷,舊版本實際消失的時間是 lifecycle 與保留期兩者中較晚的那個。
- 沒開版本控制的話,只要
Expiration和AbortIncompleteMultipartUpload。
# 用管理者身分執行,不是備份主機的 role
aws s3api put-bucket-lifecycle-configuration \
  --bucket my-db-backups \
  --lifecycle-configuration file://lifecycle.json \
  --region us-east-1
坑 2:預設動作不一定是「刪除」。這是我在 OCI 真的踩到的:生命週期規則表單的預設動作是「移至封存」。照預設存下去,30 天後備份會被搬去封存而不是刪掉,費用一路累積。不管哪家雲,建完規則都要回頭確認動作。
儲存類別
S3 的 Standard 沒有最短計費天數,最單純;Standard-IA 最短 30 天、每個物件最小以 128 KB 計費,跟 30 天刪除不衝突;Glacier Instant Retrieval 最短 90 天,第 30 天刪掉仍要補收到 90 天。用 IA 的話要在上傳時直接指定(--s3-storage-class STANDARD_IA),而且 7 天就清掉的舊版本、244 bytes 的 SHA256SUMS 都會照最低標準計費。我的量很小,用 Standard 最省事。
最後一個 IAM 管不到的風險:有 PutObject 的主機,仍然可以大量寫入垃圾物件把費用拉高。
監控與告警
| 規則 | 條件 | for | 沒資料時 | 等級 |
|---|---|---|---|---|
| 備份超過 26 小時沒成功 | 距上次成功 > 26 小時 | 10m | Alerting | critical |
| 備份超過 26 小時沒上傳到雲端 | 距上次上傳成功 > 26 小時 | 10m | Alerting | critical |
| 備份檔大小異常縮水 | < 近 3 天最大值的 50% | 0s | OK | warning |
# backup-stale:備份超過 26 小時沒成功
(time() - mysql_backup_last_success_timestamp_seconds) / 3600 > 26

# backup-upload-stale:超過 26 小時沒上傳到雲端
(time() - mysql_backup_upload_last_success_timestamp_seconds) / 3600 > 26

# backup-shrunk(初版):備份大小不到近 3 天最大值的一半
mysql_backup_size_bytes
  / max_over_time(mysql_backup_size_bytes[3d] offset 1h)
< 0.5- 26 小時 = 24 小時週期加 2 小時緩衝。
- 前兩條「沒資料」也當事故:不知道備份狀態本身就是問題。縮水告警則相反,新增資料庫時還沒有 3 天的基準,不要誤報。
- 成功與上傳分兩條:本機成功但雲端沒上去,在「整台機器壞掉」時等於沒有備份。
offset 1h讓當下這筆新值不被算進自己的分母。
縮水告警被我自己觸發了
app_a 有一張 Laravel Telescope 的 telescope_entries 表長期沒清,佔了整個資料庫的 71%(289 MB、46.5 萬筆)。清到只剩 12 筆之後,備份從 26 MB 掉到 3.7 MB,告警正確地響了。
我先設了 3 天的 Silence,但 Silence 期間真的出事也收不到,所以改寫表達式,把比較基準重設到清空之後:
mysql_backup_size_bytes
  / max_over_time(
      (mysql_backup_size_bytes and on() (vector(time()) > 1790000000))[3d:5m] offset 1h
    )
  < 0.5
# 1790000000 = 基準重設的時間點(示意值,請換成你自己清空表的 Unix 時間)
and on() (vector(time()) > T0) 在 time() 還沒超過 T0 時回傳空集合,subquery 的 [3d:5m] 就會忽略 T0 之前的樣本,舊的 26 MB 不再算進「近 3 天最大值」。我驗證過:T0 之後還沒有樣本時查詢回空;換成較早的 T0 能算出各庫比值(0.956、1.0、0.874)。改完把 Silence 提前結束。
這個條件有保存期限:窗口是 [now−3d−1h, now−1h],T0 加 3 天又 1 小時之後條件恆真,就可以拿掉。
還原演練:真的還原得回來嗎
前面的檢查(Dump completed、SHA256、告警)只能證明「檔案是完整的」,不能證明「灌回去會得到同樣的資料庫」。唯一的證明方法是真的還原一次。原則是完全不碰正式資料庫:
- 從雲端下載,不用本機那份:整台機器壞掉時你只有雲端的。下載後先驗 SHA256。
- 臨時容器用與正式機同一個 image ID(
.Image,不是.Config.Image的 tag;主機重新 pull 過mysql:8.0就可能是不同小版本),並且--network none完全斷網。 - root 密碼每次隨機產生,只放在環境變數,不進命令列;
trap cleanup EXIT保證結束時刪掉容器與暫存目錄。 - 正式機只做唯讀查詢,用同一個
backup帳號。 - 要比對的表清單從正式端列出,整張表或整個庫沒還原也抓得到;任何一步失敗或比對不一致都
exit 1,可以排程。
演練腳本如下(去識別化,已含審稿後的修正):
#!/bin/bash
# 還原演練:雲端下載最新備份 → 驗 SHA256 → 還原到斷網臨時容器 → 與正式 DB 比對 → 刪容器
# 結束碼:0 = 一致(允許清單內的表筆數不同只警告);1 = 任何一步失敗或不一致
set -euo pipefail
RCLONE="/usr/local/bin/rclone --config /etc/rclone/rclone.conf"
REMOTE=s3-backup:my-db-backups/mysql
PROD=mysql-db
MYCNF=/etc/mysql-backup.cnf
ALLOW_DIFF="telescope_entries telescope_entries_tags sessions"   # 備份後仍持續寫入的表
SCOPE="NOT IN ('mysql','sys','performance_schema','information_schema')"

WORK=$(mktemp -d /var/tmp/restore-drill.XXXX); chmod 700 "$WORK"
NAME=restore-drill-$$
cleanup() { docker rm -f "$NAME" >/dev/null 2>&1 || true; rm -rf "$WORK"; }
trap cleanup EXIT
fail() { echo "FAIL: $*" >&2; exit 1; }

# 臨時 root 密碼只放在環境變數;docker run/exec 的 -e 只寫變數名,不進命令列
PW=$(head -c 24 /dev/urandom | base64 | tr -dc A-Za-z0-9)
export MYSQL_ROOT_PASSWORD="$PW" MYSQL_PWD="$PW"

prod()  { docker exec -i "$PROD" mysql --defaults-extra-file=/dev/stdin -N -B -e "$1" < "$MYCNF"; }
drill() { docker exec -e MYSQL_PWD "$NAME" mysql -uroot -N -B -e "$1"; }
wait_ok() {  # wait_ok <次數> <指令...>:每 2 秒試一次
  local n=$1 i; shift
  for i in $(seq 1 "$n"); do "$@" >/dev/null 2>&1 && return 0; sleep 2; done
  return 1
}
is_allowed() { case " $ALLOW_DIFF " in *" $1 "*) return 0 ;; esac; return 1; }

# 1. 下載雲端最新一份,驗 SHA256
latest=$($RCLONE lsf --dirs-only "$REMOTE" | sort | tail -1 | tr -d /)
[ -n "$latest" ] || fail "雲端沒有任何備份"
t0=$(date +%s)
$RCLONE copy "$REMOTE/$latest" "$WORK/$latest"
(cd "$WORK/$latest" && sha256sum -c --quiet SHA256SUMS) || fail "SHA256 校驗失敗"
compgen -G "$WORK/$latest/*.sql.gz" >/dev/null || fail "沒有任何 .sql.gz"
echo "== $latest:下載+校驗 $(( $(date +%s) - t0 )) 秒,$(du -sh "$WORK/$latest" | cut -f1),SHA256 全部通過"

# 2. 與正式機「同一個 image ID」、完全斷網的臨時容器
IMG=$(docker inspect --type container -f '{{.Image}}' "$PROD")
docker run -d --name "$NAME" --network none -e MYSQL_ROOT_PASSWORD "$IMG" >/dev/null
wait_ok 90 docker exec -e MYSQL_PWD "$NAME" mysqladmin -uroot ping --silent || fail "臨時容器沒起來"
# 初始化會重啟一次 mysqld,再確認一次真正可用
sleep 5
wait_ok 30 drill 'SELECT 1' || fail "臨時容器無法查詢"

# 3. 匯入:任何一庫失敗就中止
t2=$(date +%s)
for f in "$WORK/$latest"/*.sql.gz; do
  zcat "$f" | docker exec -i -e MYSQL_PWD "$NAME" mysql -uroot || fail "匯入失敗:$f"
done
t3=$(date +%s); echo "== 匯入 $((t3-t2)) 秒"

# 4. 物件數;範圍以「正式端」的非系統庫為準
rc=0
meta_q="SELECT 'tables',COUNT(*) FROM information_schema.tables WHERE table_schema $SCOPE AND table_type='BASE TABLE'
 UNION ALL SELECT 'views',COUNT(*) FROM information_schema.views WHERE table_schema $SCOPE
 UNION ALL SELECT 'routines',COUNT(*) FROM information_schema.routines WHERE routine_schema $SCOPE
 UNION ALL SELECT 'triggers',COUNT(*) FROM information_schema.triggers WHERE trigger_schema $SCOPE
 UNION ALL SELECT 'events',COUNT(*) FROM information_schema.events WHERE event_schema $SCOPE"
pm=$(prod "$meta_q") || fail "正式端查詢失敗"
dm=$(drill "$meta_q") || fail "還原端查詢失敗"
echo "== 物件數(正式 | 還原)"; paste <(echo "$pm") <(echo "$dm" | cut -f2)
[ "$pm" = "$dm" ] || { echo "  物件數不一致"; rc=1; }

# 5. 表清單從「正式端」列出,與還原端 diff;再逐表 COUNT(*)
tq="SELECT CONCAT(table_schema,'.',table_name) FROM information_schema.tables WHERE table_schema $SCOPE AND table_type='BASE TABLE' ORDER BY 1"
ptables=$(prod "$tq") || fail "正式端查詢失敗"
dtables=$(drill "$tq") || fail "還原端查詢失敗"
diff <(echo "$ptables") <(echo "$dtables") || { echo "  表清單不一致(< 只有正式端有)"; rc=1; }
n=0; same=0; warn=0; tp=0; td=0
for t in $ptables; do
  q="SELECT COUNT(*) FROM \`${t%%.*}\`.\`${t#*.}\`"
  a=$(prod "$q") || fail "正式端查詢失敗:$t"
  b=$(drill "$q" 2>/dev/null) || b="缺表"
  n=$((n+1)); tp=$((tp+a)); [ "$b" = "缺表" ] || td=$((td+b))
  if [ "$a" = "$b" ]; then same=$((same+1))
  elif [ "$b" != "缺表" ] && is_allowed "${t#*.}"; then warn=$((warn+1)); echo "  警告(允許清單):$t 正式 $a|還原 $b"
  else echo "  不同:$t 正式 $a|還原 $b"; rc=1
  fi
done
[ "$n" -gt 0 ] || rc=1
echo "表 $n 張,筆數相同 $same 張,允許清單內不同 $warn 張;總筆數 正式 $tp|還原 $td"
echo "== 總耗時 $(( $(date +%s) - t0 )) 秒;結果:$([ "$rc" = 0 ] && echo PASS || echo FAIL)"
exit "$rc"
官方 MySQL image 第一次初始化時會重啟一次 mysqld,第一次 ping 通了不代表真的可用,所以再用 SELECT 1 確認。
10/16 的結果
10/16 早上,拿雲端最新一份(台北 10/16 03:00 的排程備份)跑了一次。當時用的是修正前的版本,它印出的欄位跟上面這版相同;差別在修正前遇到失敗不會中止、表清單從還原端列出、最後一律 exit 0。
| 項目 | 結果 |
|---|---|
| 下載+SHA256 校驗 | 1 秒,6.0 MB,全部通過 |
| 匯入 3 個庫 | 17 秒 |
| 物件數(正式|還原) | tables 56|56;view、routine、trigger、event 皆為 0|0 |
| 逐表 COUNT(*) | 56 張中 54 張相同 |
| 總筆數(正式|還原) | 526,850|520,143 |
| 從開始下載到比對完成 | 41 秒 |
| 事後殘留(手動確認) | 臨時容器 0 個、暫存目錄 0 個 |
不同的兩張都是 Telescope 的:telescope_entries(正式 36,466|還原 31,434)與 telescope_entries_tags(12,117|10,442)。備份在 03:00,演練在 8 點多,這幾個小時 Telescope 一直在寫,正式機自然比較多;修正版把這兩張和 10/13 演練時也出現差異的 sessions 放進允許清單,只警告、不判失敗。
部署修正版之後,我馬上拿剛上傳的備份再跑一次,這次用的就是上面這支腳本:
| 項目 | 結果 |
|---|---|
| 下載+SHA256 校驗 | 1 秒,6.3 MB,全部通過 |
| 臨時容器 | 與正式機同一個 image ID,--network none |
| 匯入 | 17 秒 |
| 表數 | 56|56 |
| 逐表筆數 | 56 張全部相同(推測是備份剛做完,持續寫入的表還來不及變動) |
| 總耗時/結果 | 41 秒,PASS(exit 0),臨時容器與暫存目錄都沒有殘留 |
要誠實補充:view、routine、trigger、event 在正式機上本來就是 0,這次沒有驗證到 --routines、--triggers、--events 與對應權限的實際效果。
第一次演練踩的坑
第一次完整還原在 10/13,還原的是 root 匯出的本機備份:三個庫 44 秒,56 張表全部還原,總筆數 1,071,694(正式機 1,071,729),差異只在持續寫入的表(app_c 的 sessions 1,008 對 1,025、app_a 的 telescope_entries 452,534 對 452,552)。那次的坑:
- 比對腳本會說謊:我用
diff ... | grep -E '^[<>]' || echo "none — identical"印結果,明明 diff 出兩行差異,還是印了「none — identical」。從此改成逐表印出不同的表。 - 演練對象不夠真:之後切成
backup帳號、改從雲端下載,都沒再完整還原過。10/16 這次就是要驗證每天實際在產生的那份備份。 - 小坑:備份目錄 700,一般帳號的 glob 展不開;
sudo的 PATH 沒有/usr/local/bin,所以腳本寫 rclone 的完整路徑。
開機碟備份與邏輯備份的分工
我另外替 VM 的開機碟設了雲端供應商的備份原則:每週一次增量,排在週一 04:00(台北),刻意在 03:00 的 MySQL 備份之後;保留 13 天,最多 2 份。它防的是整台 VM 壞掉、改規格前的退路;mysqldump 防的是誤刪資料、單庫還原。
開機碟備份不是應用層一致的,我沒確認過從它還原的 MySQL 能不能乾淨啟動,所以資料庫還原仍以 mysqldump 為準。而且第一份要到 10/19 才會產生,還沒演練過。
誠實的限制與下一步
- 跟正式機在同一個雲端帳號、同一個區域:雲端這份防的是「這台 VM 壞掉或被入侵」,防不了整個帳號出事(被盜、停權、付款問題)或整個區域故障。要防這層得再複製一份到另一個帳號或另一家廠商(例如跨帳號/跨區複製),我沒有做。
- 「刪不掉」不等於「一定救得回來」:雲端保留 30 天,代表我最多有 30 天發現入侵。攻擊者只要讓之後的備份壞掉(或停掉)再等 30 天,入侵前的好備份就會被生命週期規則清掉。而且告警用的指標是這台主機自己寫的,主機被拿下後可以造假,縮水告警看的大小、上傳的內容也一樣。緩解方向:用 Object Lock 讓保留期長於生命週期,拉長發現的時間窗(費用跟著增加);或另外保留較長天數的月備份;最根本的是從主機以外的地方(另一台機器、另一個帳號)定期檢查 bucket 最新物件的時間與大小。這些我都還沒做。
- 演練只比對筆數,沒有比對內容:筆數一樣不代表每一列都一樣。要更嚴格,可以對靜態的表做
CHECKSUM TABLE,或用 pt-table-checksum 這類工具。 - 修正版剛上線:目前只有一次手動觸發與一次演練,還需要觀察幾天的排程結果,失敗路徑也只在模擬環境測過。
- 沒有時間點還原:一天一次,最壞掉一天的資料。binlog 有開(ROW、保留 30 天),但沒上傳到雲端,也沒演練過用它補差異。
- 沒有客戶端加密:雲端靠私有 bucket 與供應商管理的金鑰。rclone 的 crypt 是可以考慮的方向。
- 帳號與權限不在備份裡:依腳本邏輯,整台重建時應用程式的 MySQL 帳號要另外建。這是推論,我還沒整台重建過。
- backup 帳號權限還能收斂:
LOCK TABLES用不到,SHOW_ROUTINE可能重複,全域SELECT可改成只對業務庫。 - 我的 OCI 環境沒有開版本控制、也沒有保留鎖定:主機刪不掉靠的是 IAM(覆寫依 policy 也不允許,但沒實測);帳號擁有者(我本人)仍可在 Console 刪除。這是防誤刪、防主機被入侵,不是合規等級的不可變儲存。
- 開機碟備份還沒演練,演練也還是手動的:只完整還原過三次(10/13、10/16 早上、10/16 部署修正版後),都是手動觸發。修正版演練腳本會依結果給 exit code,下一步是排進固定行程。
小結
- 「備份成功」要定義清楚,失敗路徑也要測:任何失敗都要走到寫指標,我的腳本就是審稿時才發現這條路斷了。
- 最小權限分兩層:MySQL 用唯讀帳號、密碼走 stdin;雲端讓主機只能上傳,用
copy不用sync。 - 不能刪不等於不能破壞:同名上傳就能覆寫,Versioning 是基本;保留天數也是發現入侵的時間上限。
- 還原演練才是真正的驗收:在我的規模下 41 秒,換來的是親眼看過「還原得回來」。
如果你用的是 OCI
| 概念 | AWS S3(正文) | OCI Object Storage(我實際用的) |
|---|---|---|
| 主機身分 | IAM role + instance profile | instance principal + dynamic group |
| 只能上傳的權限 | 只給 PutObject、GetObject、AbortMultipartUpload、ListBucket | manage objects 搭配 request.permission 白名單,只放 OBJECT_CREATE、OBJECT_INSPECT、OBJECT_READ |
| 未授權刪除的回應 | 拒絕 | 回 404(NotAuthorizedOrNotFound),不回 403 |
| 同名覆寫 | PutObject 就能覆寫 | 獨立的 OBJECT_OVERWRITE 權限,白名單裡沒有(沒實測覆寫) |
| 30 天自動刪除 | Lifecycle | 生命週期規則(預設動作是「移至封存」,要改成「刪除」);要另外授權 Object Storage 服務本身執行 |
| 清除未完成的分段上傳 | AbortIncompleteMultipartUpload | 建 bucket 時的「清除未確認的多段上傳」選項 |
| rclone 認證 | type = s3、env_auth = true |
type = oracleobjectstorage、provider = instance_principal_auth |
Dynamic group 只比對這一台 VM 的 instance OCID,避免同一個 compartment 日後新開的機器自動拿到權限:
# Dynamic group 比對規則:只比對這一台 VM 的 instance OCID
instance.id = '<這台 VM 的 instance OCID>'
Policy 三行(去識別化)。第 1 行能讀取這個 bucket;第 2 行 manage objects 本來包含刪除,用 request.permission 白名單只放行建立、列出、讀取;第 3 行授權 Object Storage 服務執行生命週期規則。第 3 行的範圍是整個 tenancy,應該可以縮小到 bucket 所在的 compartment,我沒試。
Allow dynamic-group '<domain>'/'<dg-name>' to read buckets in tenancy where target.bucket.name = 'my-db-backups'
Allow dynamic-group '<domain>'/'<dg-name>' to manage objects in tenancy where all {target.bucket.name = 'my-db-backups', any {request.permission = 'OBJECT_CREATE', request.permission = 'OBJECT_INSPECT', request.permission = 'OBJECT_READ'}}
Allow service objectstorage-<region> to manage object-family in tenancy這三行是依我存檔時輸入的內容整理的,存檔後沒有讀回原文核對,只有刪除測試佐證;照抄前請以 Console 實際存下的文字為準,特別是 any {...} 的巢狀語法。生命週期規則套在整個 bucket 還是某個前綴,我也沒記錄,所以那個刪不掉的測試檔會不會被清掉,我不確定。
[oci]
type = oracleobjectstorage
provider = instance_principal_auth
namespace = <namespace>
compartment = <tenancy OCID>
region = <region>
實測:上傳、列出、讀取都成功;刪除回 Status Code: 404,檔案仍在。新版 Console 的生命週期規則在 bucket 的「原則」分頁。
附錄:完整備份腳本
去識別化版本:雲端 remote 換成 S3、為了 --s3-no-check-bucket 多兩行,其他與修正版一致。修正版已於 10/16 部署到正式主機。安裝方式:sudo install -o root -g root -m 750 mysql-backup.sh /usr/local/sbin/,再 systemctl start mysql-backup.service 手動跑一次確認指標。
#!/bin/bash
# MySQL 每日備份:mysqldump → gzip → 本機保留 7 天 → 上傳 S3
# 結果寫成 node-exporter textfile 指標,由 Grafana 告警監控
# 任何一步失敗都會走到「寫指標」(success 0、最後成功時間保留舊值),最後 exit 1
set -euo pipefail

CONTAINER=mysql-db
BACKUP_ROOT=/var/backups/mysql
LOCAL_KEEP_DAYS=7
RCLONE=/usr/local/bin/rclone
RCLONE_REMOTE=s3-backup:my-db-backups/mysql
RCLONE_CONF=/etc/rclone/rclone.conf
TEXTFILE_DIR=/var/lib/node_exporter/textfile
METRICS=$TEXTFILE_DIR/mysql_backup.prom
SLOWLOG_METRICS=$TEXTFILE_DIR/mysql_slowlog.prom
MYCNF=/etc/mysql-backup.cnf   # backup 帳號(唯讀),經 stdin 傳入容器,不落地
SLOWLOG_DIR=/var/backups/mysql-slowlog
SLOWLOG_KEEP=4

start=$(date +%s)
ts=$(date -u +%Y%m%dT%H%M%SZ)
out=$BACKUP_ROOT/$ts

declare -A sizes
ok=1            # 本機備份是否完整(全部庫都 dump 成功、SHA256SUMS 已產生)
upload_ok=0     # 這次是否已上傳到雲端
metrics_done=0  # mysql_backup.prom 是否已寫出(給 EXIT trap 判斷)

mysql_q() {
  docker exec -i "$CONTAINER" mysql --defaults-extra-file=/dev/stdin -N -B -e "$1" < "$MYCNF"
}

# 把 stdin 的內容原子寫成 textfile:同目錄 mktemp(以 . 開頭、不以 .prom 結尾)→ chmod 644 → mv
publish() {
  local target=$1 name tmp
  name=$(basename "$target" .prom)
  tmp=$(mktemp "$TEXTFILE_DIR/.$name.XXXX") || return 1
  cat > "$tmp" && chmod 644 "$tmp" && mv "$tmp" "$target"
}

write_metrics() {
  local end prev_ok prev_up db
  end=$(date +%s)
  # 成功時間只在成功時更新,失敗時保留上一次成功的值
  prev_ok=$(grep -h '^mysql_backup_last_success_timestamp_seconds' "$METRICS" 2>/dev/null | awk '{print $2}' || true)
  prev_up=$(grep -h '^mysql_backup_upload_last_success_timestamp_seconds' "$METRICS" 2>/dev/null | awk '{print $2}' || true)
  {
    echo "# HELP mysql_backup_last_run_timestamp_seconds 最近一次執行備份的時間"
    echo "# TYPE mysql_backup_last_run_timestamp_seconds gauge"
    echo "mysql_backup_last_run_timestamp_seconds $end"
    echo "# TYPE mysql_backup_success gauge"
    echo "mysql_backup_success $ok"
    echo "# TYPE mysql_backup_duration_seconds gauge"
    echo "mysql_backup_duration_seconds $((end - start))"
    echo "# TYPE mysql_backup_upload_success gauge"
    echo "mysql_backup_upload_success $upload_ok"
    echo "# TYPE mysql_backup_size_bytes gauge"
    for db in "${!sizes[@]}"; do echo "mysql_backup_size_bytes{db=\"$db\"} ${sizes[$db]}"; done
    echo "# TYPE mysql_backup_last_success_timestamp_seconds gauge"
    echo "mysql_backup_last_success_timestamp_seconds $([ "$ok" = 1 ] && echo "$end" || echo "${prev_ok:-0}")"
    echo "# TYPE mysql_backup_upload_last_success_timestamp_seconds gauge"
    echo "mysql_backup_upload_last_success_timestamp_seconds $([ "$upload_ok" = 1 ] && echo "$end" || echo "${prev_up:-0}")"
  } | publish "$METRICS"
  metrics_done=1
}

# 失敗的目錄改名為 .failed,而不是刪除:留下最近一次失敗的現場(被截斷的 dump)方便除錯,
# 又不會被 ls 誤認為正常備份、也不會被上傳。下一次執行開始時會清掉舊的 .failed,
# 避免「磁碟滿 → 失敗 → 失敗目錄越積越多」。
mark_failed() {
  if [ -d "$out" ]; then
    mv "$out" "$out.failed" && echo "backup dir renamed to $out.failed" >&2
  fi
}

# 安全網:預期外的錯誤讓 set -e 中斷時,仍然寫出 success 0 的指標
on_exit() {
  local rc=$?
  set +e
  if [ "$metrics_done" = 0 ]; then
    echo "unexpected failure (exit $rc) before metrics were written" >&2
    ok=0
    mark_failed
    write_metrics
    exit 1
  fi
}
trap on_exit EXIT
trap 'exit 143' TERM INT   # 被 systemd 停掉時也走 EXIT trap

mkdir -p "$BACKUP_ROOT" "$TEXTFILE_DIR"
chmod 700 "$BACKUP_ROOT"
find "$BACKUP_ROOT" -mindepth 1 -maxdepth 1 -type d -name '*.failed' -exec rm -rf {} +
mkdir -p "$out"

# 1. 列出要備份的庫。MySQL 或容器掛掉時,指派本身會失敗,不能讓 set -e 直接結束
if ! dbs=$(mysql_q "SELECT schema_name FROM information_schema.schemata WHERE schema_name NOT IN ('mysql','sys','performance_schema','information_schema')"); then
  echo "cannot list databases (MySQL unreachable?)" >&2
  dbs=""
fi
[ -n "$dbs" ] || { echo "no databases found" >&2; ok=0; }

# 2. 逐庫 dump,最後一行必須是 -- Dump completed(if 條件裡 set -e 不作用,pipefail 仍決定管線結果)
for db in $dbs; do
  f=$out/$db.sql.gz
  errf=$(mktemp)
  if docker exec -i "$CONTAINER" mysqldump --defaults-extra-file=/dev/stdin \
        --single-transaction --quick --routines --triggers --events --hex-blob \
        --set-gtid-purged=OFF --databases "$db" < "$MYCNF" 2>"$errf" | gzip -6 > "$f" \
     && zcat "$f" | tail -n 1 | grep -q '^-- Dump completed'; then
    sizes[$db]=$(stat -c %s "$f")
    echo "ok   $db $(du -h "$f" | cut -f1)"
  else
    echo "FAIL $db"; cat "$errf" || true
    ok=0
  fi
  rm -f "$errf"
done

# 3. SHA256SUMS:只對完整的備份算;沒有任何 dump 檔也算失敗
if [ "$ok" = 1 ] && compgen -G "$out/*.sql.gz" >/dev/null; then
  (cd "$out" && sha256sum -- *.sql.gz > SHA256SUMS) || ok=0
else
  ok=0
fi

# 4. 只有本機備份完整才上傳
if [ "$ok" = 1 ]; then
  if [ ! -f "$RCLONE_CONF" ]; then
    echo "upload FAILED: $RCLONE_CONF not found" >&2
  # S3 版多加 --s3-no-check-bucket(依 rclone 文件整理;我實跑的 OCI 版沒有這個旗標)
  elif "$RCLONE" --config "$RCLONE_CONF" copy "$out" "$RCLONE_REMOTE/$ts" \
         --s3-no-check-bucket --retries 3 --low-level-retries 5; then
    upload_ok=1; echo "uploaded to $RCLONE_REMOTE/$ts"
  else
    echo "upload FAILED" >&2
  fi
fi

# 5. 本機保留:只有成功時才清舊備份(連續失敗時不會把好的備份刪光);失敗的目錄改名
#    上傳失敗不算本機失敗:本機這份是完整的,照常保留、照常清理
if [ "$ok" = 1 ]; then
  find "$BACKUP_ROOT" -mindepth 1 -maxdepth 1 -type d -mtime +$((LOCAL_KEEP_DAYS - 1)) -exec rm -rf {} +
else
  mark_failed
fi

# 6. 寫指標(到這裡之前的任何失敗都已經反映在 ok / upload_ok)
write_metrics

# 7. 慢查詢 log 輪替(與備份無關,放在寫完指標之後;失敗不影響備份結果)
#    主機 logrotate 被 SELinux 擋、讀不到 Docker volume,所以由這支每天會跑的腳本順手處理。
#    每週日(台北時間)或超過 50MB 時壓縮存到 SLOWLOG_DIR,保留 4 份,原檔清空。
#    在 || 左邊呼叫的函式裡 set -e 不作用,所以每一步都要自己 || return 1:
#    特別是 cat 失敗時絕不能繼續清空原檔。
#    已知限制:cat 與清空之間寫入的慢查詢會遺失;改用 FLUSH SLOW LOGS 需要 RELOAD 權限,
#    與 backup 帳號唯讀的原則衝突,所以維持現狀。
rotate_slowlog() {
  local slowlog slowsize
  slowlog=$(mysql_q "SELECT @@slow_query_log_file") || return 1
  [ -n "$slowlog" ] || return 0
  slowsize=$(docker exec "$CONTAINER" stat -c %s "$slowlog" 2>/dev/null || echo 0)
  [ "$(TZ=Asia/Taipei date +%u)" = 7 ] || [ "$slowsize" -gt 52428800 ] || [ "${FORCE_SLOWLOG_ROTATE:-0}" = 1 ] || return 0
  mkdir -p "$SLOWLOG_DIR" && chmod 700 "$SLOWLOG_DIR" || return 1
  docker exec "$CONTAINER" cat "$slowlog" | gzip -6 > "$SLOWLOG_DIR/slow-$ts.log.gz" || { rm -f "$SLOWLOG_DIR/slow-$ts.log.gz"; return 1; }
  docker exec "$CONTAINER" sh -c ': > "$0"' "$slowlog" || return 1
  ls -1t "$SLOWLOG_DIR"/slow-*.log.gz | tail -n +$((SLOWLOG_KEEP + 1)) | xargs -r rm -f || return 1
  echo "slow log rotated ($slowsize bytes)"
}
if rotate_slowlog; then
  slow_ok=1
else
  slow_ok=0; echo "slow log rotate FAILED(不影響備份結果)" >&2
fi
{
  echo "# TYPE mysql_slowlog_rotate_success gauge"
  echo "mysql_slowlog_rotate_success $slow_ok"
} | publish "$SLOWLOG_METRICS" || echo "cannot write $SLOWLOG_METRICS" >&2

[ "$ok" = 1 ] && [ "$upload_ok" = 1 ] || exit 1
系列文章:自架 VM 維運實戰
保護 → 部署 → 觀測 → 調校 → 備份 → AI 協作,建議依序閱讀:
- 第 1 篇:【資安】Cloudflare Access 實戰:不用 VPN 保護後台與 Grafana
- 第 2 篇:【CI/CD】Jenkins 打造安全的 Laravel 部署:JCasC 與受限 SSH
- 第 3 篇:【監控】Prometheus + Grafana 監控 Docker 服務與 Slack 告警
- 第 4 篇:【監控】Loki + Alloy 集中 Laravel 與 Nginx Log:遮罩與踩坑
- 第 5 篇:【效能】k6 壓測 Laravel Octane:找出 2 核 VM 的真實上限
- 第 6 篇:【備份】MySQL 每日備份上雲:只能上傳不能刪,還要真的還原得回來(本篇)
- 第 7 篇:【AI】讓 AI 安全查 Grafana:自架官方 mcp-grafana 的五層防護
No comments yet.