前言
我的正式環境一直很單純:一台 VM,上面用 docker compose 跑幾個 Laravel 服務,前面一個 nginx 依子網域反代。前面「自架 VM 維運實戰」系列(從第 1 篇的 Cloudflare Access 一路寫到監控、備份與 AI 查 Grafana)都是在這台機器上做的。它跑得很穩;這次想把其中兩個服務搬上 k8s 練一輪,看看要改哪些東西。
【系列】從 docker compose 到 k3s 第 1 篇
(下一篇:【k8s】把 docker compose 上的 Laravel 搬上 Kubernetes(下):Helm chart、queue worker 與 CronJob)
先講範圍,避免誤會:
- 全程只在 Mac 上做,用 OrbStack 內建的單節點 Kubernetes,不碰正式 VM。
- 資料庫只用假資料(原本規劃用 seed 產生,blog 的 seeder 問題見後文),正式資料不複製到 Mac;密碼也都是練習用的假值。
- 目標只有一句話:在空叢集上一行指令部署整個服務,能滾動更新、也能回滾。
環境如下:
| 項目 | 內容 |
|---|---|
| 機器 | Mac mini:macOS 26.6.2、Apple Silicon(arm64)、10 核、16 GB |
| Kubernetes | OrbStack 內建單節點叢集,kubectl 1.33.9 |
| 工具 | helm、k9s(brew install helm k9s;helm 的版本我的紀錄沒寫) |
| image 來源 | Mac 本機 build,OrbStack 的 k8s 直接用本機 image,不需要 registry(推 GHCR 留到之後) |
| CPU 架構 | 正式 VM 也是 ARM64,image 不用跨架構 build |
不推 registry 是為了少一個環節,代價是這套做法只在這台 Mac 上成立。另一個坑:開始前 Mac 磁碟只剩 10 GiB(98%),image、volume 很吃空間,先清到至少 30 GiB 才開工。
關於文中的程式碼。這次練習是在另一台 Mac mini 上完成並驗收的,文中的數字都是當時實測;但練習的 repo 不在我寫這篇的電腦上,所以文中的 Dockerfile、YAML 與指令都是精簡過的示意寫法,不是 repo 原文,每段第一行都會標「示意」。為了好讀,片段多半省略了
envFrom(ConfigMap/Secret)與部分欄位,image tag 寫的是渲染後的樣子。
文中兩個服務:一個是 blog(就是這個部落格),另一個是用 Laravel Octane 寫的服務,文中稱為 app-b。上篇講 image、架構與零中斷滾動更新,Helm chart 與背景工作留到下篇。
最大的觀念轉換:程式碼要做進 image
在 docker compose 上,我的習慣是把主機上的程式碼目錄掛進容器:image 只提供 PHP 執行環境,部署就是在主機上更新程式碼。這在 k8s 上行不通,Pod 可能被排到任何節點、隨時被砍掉重建,不能假設主機上有一份程式碼可以掛。所以 image 本身要帶著程式碼,「部署一個版本」等於「換一個 image tag」。
做法是另外寫一份給 k8s 用的 multi-stage Dockerfile,現有的 compose 不動。blog 是 php-fpm 搭 nginx,有一個容易漏掉的細節:nginx 也要拿得到 public/ 底下的靜態檔。compose 時代兩個容器掛同一個主機目錄就好;程式碼進了 image 之後,其中一種做法是從同一份 Dockerfile 多做一個只帶 public/ 的 nginx image:
# 示意(精簡過,不是 repo 原文;PHP 版本與 extension 依你的專案調整)
# 第 1 段:只裝正式環境需要的依賴
FROM composer:2 AS vendor
WORKDIR /app
COPY composer.json composer.lock ./
# 這個 stage 沒裝 PHP extension,才先忽略平台檢查;實際需要的 extension 在第 2 段補齊
RUN composer install --no-dev --no-scripts --no-autoloader --prefer-dist --no-interaction --ignore-platform-reqs

# 第 2 段:php-fpm,程式碼直接 COPY 進 image
FROM php:8.3-fpm AS app
WORKDIR /var/www/html
# Laravel 預設 REDIS_CLIENT=phpredis,要裝 redis extension
RUN docker-php-ext-install pdo_mysql \
 && pecl install redis && docker-php-ext-enable redis
COPY --from=composer:2 /usr/bin/composer /usr/bin/composer
# 一定要搭配 .dockerignore,擋掉 .env 與本機的 vendor/
COPY . .
COPY --from=vendor /app/vendor ./vendor
RUN composer dump-autoload --optimize --no-dev \
 && chown -R www-data:www-data storage bootstrap/cache
# 不要在 build 時跑 php artisan config:cache,否則之後 ConfigMap/Secret 給的 env 不會生效

# 第 3 段:nginx 只需要 public/ 的靜態檔
FROM nginx:1.27-alpine AS web
COPY docker/k8s/nginx.conf /etc/nginx/conf.d/default.conf
COPY --from=app /var/www/html/public /var/www/html/public
幾個照抄時容易踩的點:
.dockerignore一定要有。至少擋掉.env、.git、vendor、node_modules、storage/logs/*。沒有它,COPY . .會把本機含 dev 套件的vendor/先複製進去,後面的COPY --from=vendor是合併不是取代,--no-dev等於白做;本機.env裡的密碼也會被做進 image。- 兩個容器的路徑要一致。nginx.conf 的
root指向/var/www/html/public,SCRIPT_FILENAME用$document_root$fastcgi_script_name,php-fpm 那邊也要在同一個路徑有這份程式碼。 - app 與 web 兩個 image 的 tag 要一起換,不然
public/的靜態檔會和程式碼版本對不上。
用 docker build --target app 與 --target web 各 build 一個 tag。這一步的完成判準是:docker run 不掛任何 volume,也能把 php-fpm 起來。只要還有任何東西偷偷依賴主機目錄,這一步就會失敗。
架構
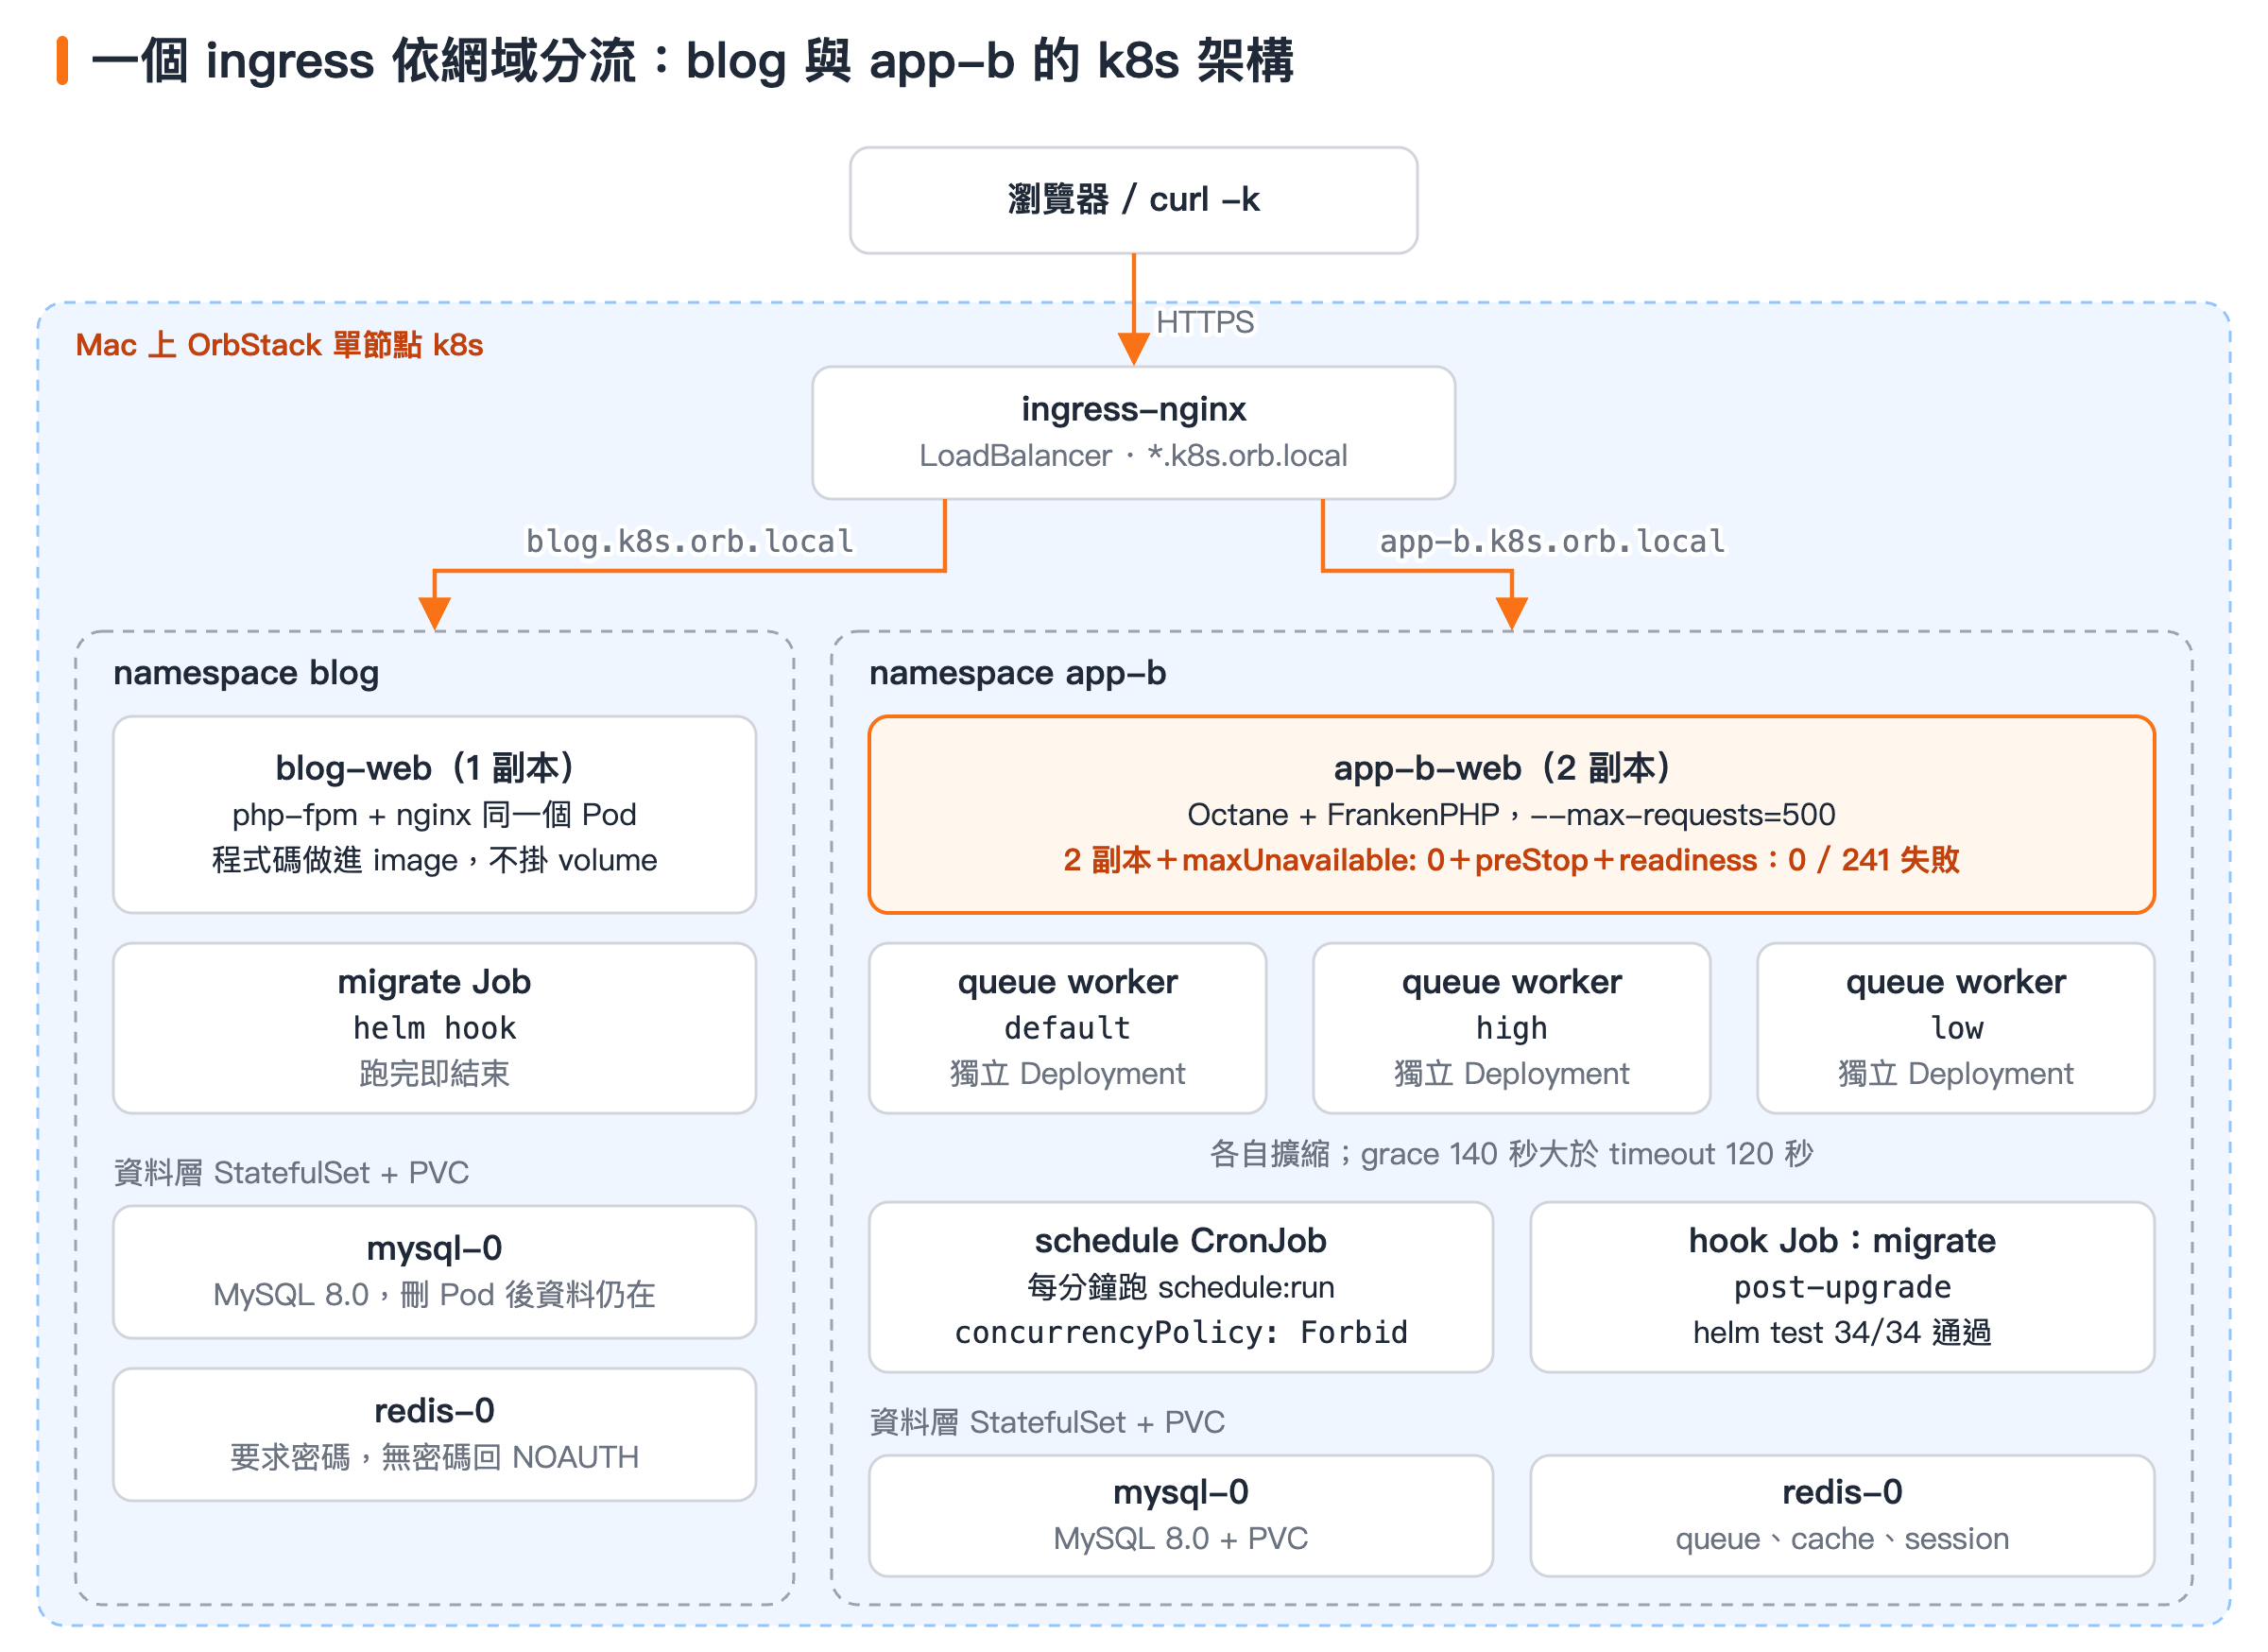
同一個 ingress 依網域分流;app-b 把 web、queue、排程拆開,各自擴縮。
最後的樣子是:1 個 ingress-nginx 依網域分流,後面 2 個 namespace,各放一個服務。blog 很單純,只有 web(1 副本,php-fpm+nginx 同一個 Pod)加資料層。app-b 比較有代表性:web(2 副本,Octane+FrankenPHP)、3 種 queue worker(default、high、low)、每分鐘的排程 CronJob,拆成各自獨立的工作負載,可以分開擴縮、分開重啟(worker 與排程在下篇)。
blog 的 php-fpm 與 nginx 放在同一個 Pod,兩個容器共用網路,nginx 把請求轉給 127.0.0.1:9000 就好;image 用 Mac 本機 build 的,imagePullPolicy 設 IfNotPresent。還沒有 ingress 之前,先用 kubectl -n blog port-forward svc/blog-web 8080:80 開首頁。這時沒有 DB,判準寫成「錯誤頁也算通」:連不上 DB 噴的是 Laravel 的錯誤頁,反而證明 nginx 已經把請求交給 php-fpm;但 nginx 回的 502 不算,那代表 nginx 根本沒接到 php-fpm。
對外入口是用 helm 裝 ingress-nginx,再用 Ingress 物件(ingressClassName: nginx)把 blog.k8s.orb.local 與 app-b.k8s.orb.local 分到各自的 Service。這對應正式 VM 上「nginx 依子網域反代」,只是規則從設定檔變成 Ingress 物件。Ingress 要和它指向的 Service 在同一個 namespace,所以 blog 與 app-b 各有一份。網址雖然是 https://,但 Ingress 沒有設定 tls: 時,ingress-nginx 會用內建的自簽憑證回應,所以本機測試要用 curl -k;對外正式使用要加 tls:,搭配 cert-manager 或自己的憑證。
八個步驟總覽
練習分成 8 個步驟,每步大約 1~2 個晚上,每一步都有一條看得到結果的完成判準:
| 步驟 | 做什麼 | 完成判準 |
|---|---|---|
| 1 準備環境 | 清磁碟、裝 helm 與 k9s、OrbStack 開 Kubernetes、kubectl config use-context orbstack | kubectl get nodes 是 Ready |
| 2 自帶程式碼的 image | 寫 k8s 用的 multi-stage Dockerfile | docker run 不掛 volume 也能起 php-fpm |
| 3 基本物件 | Namespace blog、Deployment(php-fpm+nginx 同一個 Pod)、Service | 用 port-forward 打開首頁(錯誤頁也算通) |
| 4 有狀態服務 | StatefulSet+PVC 跑 MySQL 8.0 與 Redis,用 Job 跑 migrate | 刪掉 MySQL Pod,重建後資料還在 |
| 5 設定與機密 | .env 拆成 ConfigMap 與 Secret | 改一個 ConfigMap 值,Pod 依序重建且新值生效 |
| 6 健康檢查與資源 | readiness/liveness probe、requests/limits | 壞掉的 Pod 不接流量;OOMKilled 後會自動重啟 |
| 7 對外入口 | 用 helm 裝 ingress-nginx,依網域分流 | 不用 port-forward,用網域就能開首頁 |
| 8 打包成 Helm chart | 練 helm upgrade 換 tag 與 helm rollback | kubectl delete ns blog 後一行 helm install 整套回來;換 tag 能滾動更新,也能回滾 |
第 2、3、7 步前面講過;以下談第 4、6 步與滾動更新,第 5、8 步在下篇。
有狀態服務:MySQL 與 Redis 用 StatefulSet
重點是 volumeClaimTemplates:每個 Pod 有自己固定的 PVC,Pod 名稱也固定是 mysql-0,砍掉重建會掛回同一份資料。另外 serviceName 要對應一個 headless Service(clusterIP: None),Pod 才有 mysql-0.mysql 這種固定 DNS,應用程式的 DB_HOST 填 mysql 即可:
# 示意(精簡過,不是 repo 原文)
apiVersion: v1
kind: Service
metadata:
  name: mysql
  namespace: blog
spec:
  clusterIP: None          # headless:給 StatefulSet 穩定 DNS
  selector:
    app: mysql
  ports:
    - port: 3306
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: mysql
  namespace: blog
spec:
  serviceName: mysql       # 對應上面的 headless Service
  replicas: 1
  selector:
    matchLabels:
      app: mysql
  template:
    metadata:
      labels:
        app: mysql
    spec:
      containers:
        - name: mysql
          image: mysql:8.0
          envFrom:
            - secretRef:
                name: blog-secret   # mysql image 讀 MYSQL_ROOT_PASSWORD、MYSQL_PASSWORD 等;值要和 Laravel 的 DB_PASSWORD 一致
          ports:
            - containerPort: 3306
          volumeMounts:
            - name: data
              mountPath: /var/lib/mysql
  volumeClaimTemplates:
    - metadata:
        name: data
      spec:
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 5Gi   # 範例值,依你的資料量調整
Redis 也是同樣結構,另外設成要求密碼(沒帶密碼會回 NOAUTH)。資料表用 Job 跑 migrate,打包成 chart 後改成 helm hook(下篇)。這一步原本規劃用 php artisan migrate --seed 順便灌假資料;後來驗收時才發現,blog 的 DatabaseSeeder 引用了一個不存在的 seeder,--seed 會失敗。完成判準是刪掉 mysql-0,等它重建後資料還在。
健康檢查與資源:故意弄壞來看反應
第 6 步做了兩個破壞實驗:
- 弄壞 readiness probe:壞的 Pod 不會被放進 Service 接流量。
- 把 memory limits 調太小:容器被 OOMKilled,之後 k8s 自動把它重啟。
readiness 直接決定這個 Pod 能不能接請求,後面的零中斷更新就建立在這個機制上,所以 probe 與 resources 的示意寫法放在下一節一起看。
零中斷滾動更新
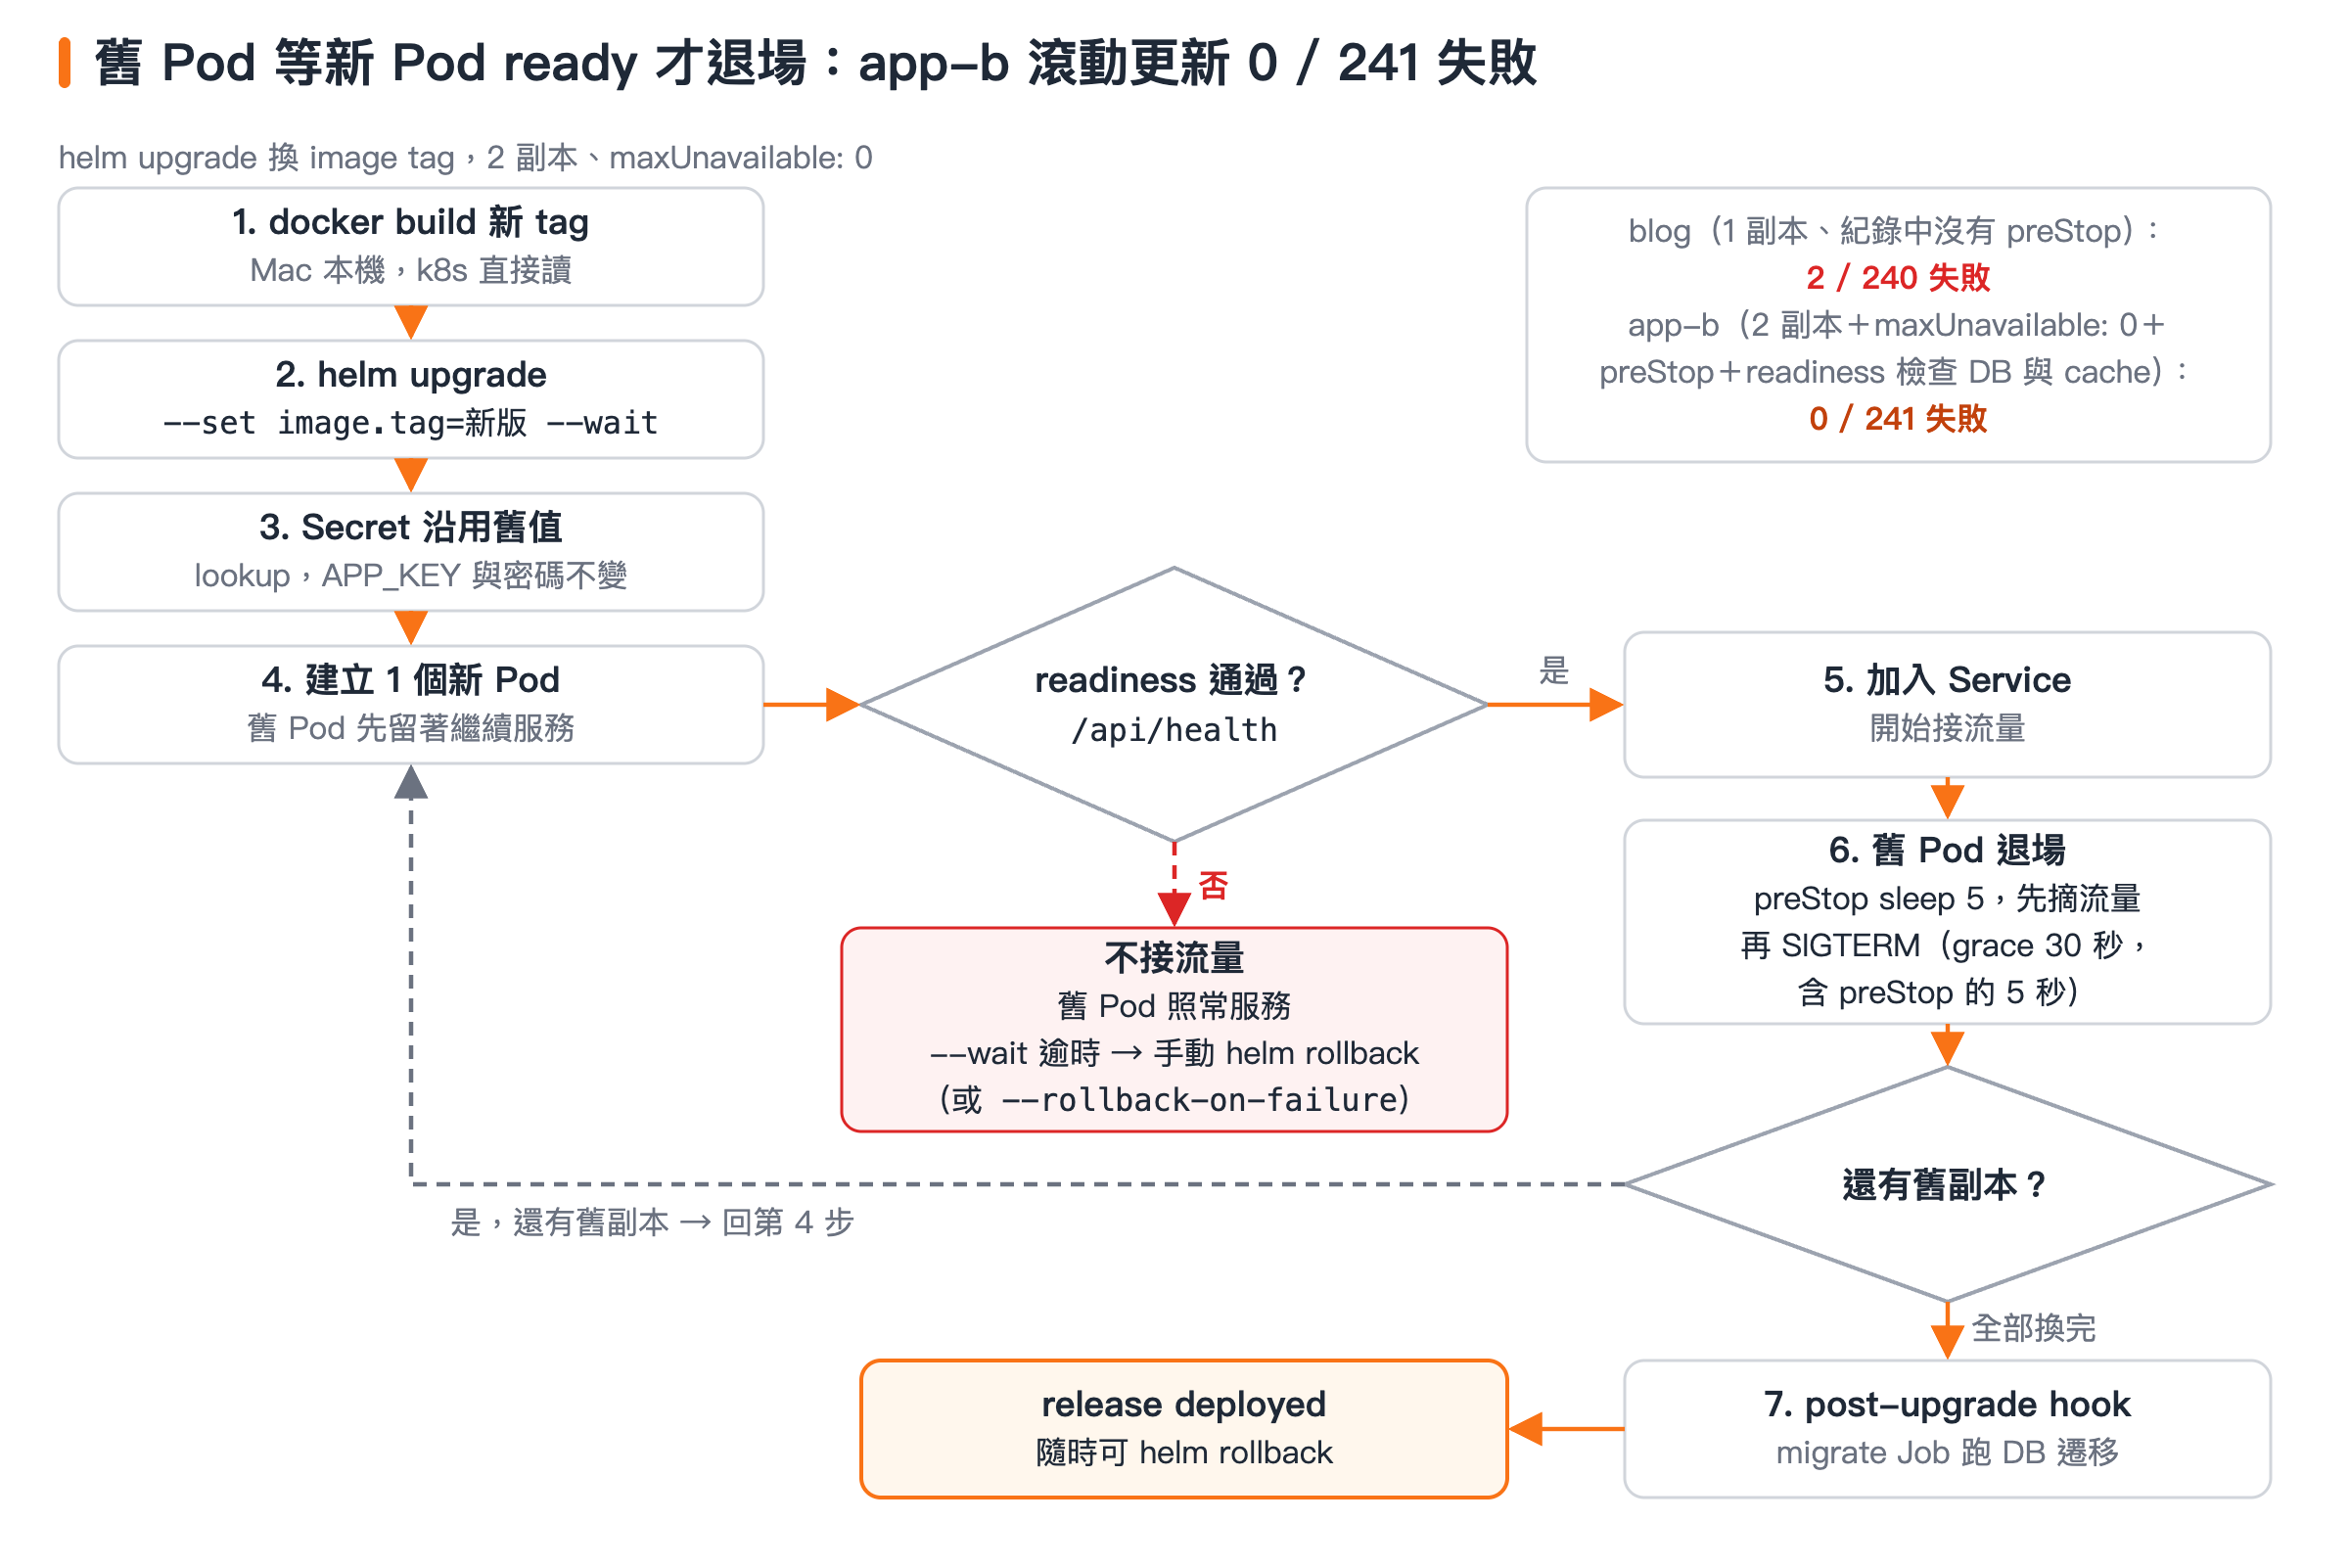
新 Pod 通過 readiness 才接流量、舊 Pod 才退場,2 副本滾動更新 0 失敗。
滾動更新期間的實測失敗次數:
| 服務 | 設定 | 失敗次數 |
|---|---|---|
| blog | 1 個副本,紀錄中沒有 preStop | 2 / 240 |
| app-b | 2 個副本+maxUnavailable: 0+preStop+會檢查 DB 與 cache 的 readiness | 0 / 241 |
流程如圖:新 Pod 先建起來,readiness(/api/health)通過才加入 Service;舊 Pod 退場時 preStop 先 sleep 5,再收到 SIGTERM;全部換完才跑 post-upgrade 的 migrate hook(hook 與 --wait 逾時的處理在下篇)。圖上有兩個細節值得補充:
- grace 30 秒是從 Pod 被刪除那一刻開始算,包含 preStop 的 5 秒。所以 SIGTERM 之後,Octane 只剩大約 25 秒收尾。
- readiness 檢查 DB 是一種取捨。好處是「程序起來了但其實還連不上 DB」的 Pod 不會提早接流量;代價是 DB 一掛,所有 web Pod 都會被摘出 Service,變成全站 503。liveness 則只看程序活著,不檢查 DB,避免 DB 一抖就把 Pod 全部重啟。
blog 的 2 次失敗,我後來的判斷
當時我以為是「blog 只有 1 個副本,第 6 步舊 Pod 退場時有短暫空窗」。但如果 blog 用的是 Deployment 預設的 strategy(我的紀錄沒寫),這個解釋站不住:預設的 maxSurge/maxUnavailable 是 25%,換算時 surge 無條件進位、unavailable 無條件捨去,1 副本會變成 surge 1、unavailable 0,也就是新 Pod ready 之前,舊 Pod 本來就不會被砍。
我後來的判斷是:比較可能是 blog 沒有設 preStop(紀錄中只有 app-b 有),舊 Pod 收到 SIGTERM 時,Service/ingress 那邊的端點還沒摘掉,少數請求打到了正在關閉的 Pod。k8s 摘流量與停程序是分頭進行的,preStop 的 sleep 5 就是在兩者之間墊一段時間。這是事後推論,我沒有再做對照實驗驗證;實測數字還是 2 / 240。
app-b 的結果也不該歸功於單一設定,而是幾件事一起成立:2 個副本、明寫 maxUnavailable: 0(1~2 副本時預設換算出來其實也是 0,明寫是為了不依賴預設值)、preStop 先墊時間、readiness 會檢查 DB 與 cache。對應的寫法大致如下,第 6 步的 probe 與 resources 也在這裡:
# 示意(精簡過,不是 repo 原文;只列跟滾動更新有關的欄位)
apiVersion: apps/v1
kind: Deployment
metadata:
  name: app-b-web
  namespace: app-b
spec:
  replicas: 2
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1          # 一次多起 1 個新 Pod
      maxUnavailable: 0    # 新 Pod ready 之前,舊 Pod 一個都不准先走
  selector:
    matchLabels:
      app: app-b-web
  template:
    metadata:
      labels:
        app: app-b-web
    spec:
      terminationGracePeriodSeconds: 30   # 從刪除開始算,含 preStop 的 5 秒
      containers:
        - name: web
          image: app-b:v2
          imagePullPolicy: IfNotPresent
          command: ["php", "artisan", "octane:start", "--server=frankenphp",
                    "--host=0.0.0.0", "--port=8000", "--max-requests=500"]
          ports:
            - containerPort: 8000
          readinessProbe:
            httpGet:
              path: /api/health   # 會檢查 DB 與 cache
              port: 8000
            periodSeconds: 5
          livenessProbe:          # liveness 只看程序活著,不檢查 DB
            tcpSocket:
              port: 8000
            initialDelaySeconds: 10
          lifecycle:
            preStop:
              exec:
                command: ["sleep", "5"]   # k8s 1.30 起也可用原生的 preStop.sleep
          resources:              # 數字依你的服務調整
            requests:
              cpu: 100m
              memory: 256Mi
            limits:
              memory: 512Mi
為什麼正式 DB 先不搬進 k8s
第 4 步的實驗本身是成功的:刪掉 mysql-0,StatefulSet 重建之後,資料還在 PVC 上。但這也讓我意識到,在 k8s 裡跑資料庫要顧的事情比 web 多很多。以下是我目前的判斷,不是通則:
- 這次的 PVC 是單節點叢集上的儲存,「Pod 重建資料還在」證明的是 Pod 層的重啟,不代表節點壞掉時資料也安全。
- 正式 VM 上的 MySQL 已經有每日備份上雲與還原演練(【備份】MySQL 每日備份上雲:只能上傳不能刪,還要真的還原得回來),這套流程搬進 k8s 要重新設計、重新驗證。
- web 與 worker 是無狀態的,搬錯了砍掉重來就好;資料庫搬錯了代價不一樣。
所以目前的方向是:先把無狀態的部分練熟,正式 DB 暫時留在原地,等 k3s 那篇跑起來再評估。
還沒做的事與誠實的限制
這是一次練習,不是可以直接上線的設定:
- 單節點。OrbStack 只有一個節點,跨節點排程、節點故障這些情境都沒有測到。
- blog 只有 1 個副本,沒有備援。滾動更新 2 / 240 失敗的原因見前文(推論,未驗證)。
- 資料層沒有 HA。MySQL 與 Redis 都是單副本 StatefulSet,k8s 內沒有備份,也沒有高可用。
- 測試條件不是正式條件。app-b 跑在
APP_ENV=local,外部依賴全是假值,0 / 241 是在這個條件下測的。 - image 沒有 registry。換到別台機器就不成立;推 GHCR 留到之後。
- 沒有真的 TLS。ingress 用的是自簽憑證。
- 練習用的 image 以 root 執行。示意的 Dockerfile 也沒有設定
USER;正式使用前應加上securityContext(runAsNonRoot: true、allowPrivilegeEscalation: false)改成非 root。 - resources、securityContext、NetworkPolicy 沒有逐一示範。本文片段只有 web 設了 resources;namespace 之間預設是全通的,正式使用要另外補。
- blog 的 seeder 有問題。
DatabaseSeeder引用了不存在的 seeder,--seed會失敗。這是 blog 原始碼本身的問題,不是 k8s 造成的,但從頭重裝時才被抓出來。
下篇預告
下篇把前 7 步的 manifest 打包成 Helm chart:ConfigMap 改了怎麼觸發重建、helm upgrade 時 Secret 怎麼不被換掉、migrate hook 與 rollback;再加上 app-b 的 queue worker 與排程 CronJob,以及請另一個 AI agent 照 README 從零重裝的驗收。
小結
- 程式碼要做進 image。multi-stage build 是搬遷的第一步,判準是「不掛 volume 也能跑」,
.dockerignore別漏。 - 有狀態服務用 StatefulSet+headless Service。刪 Pod 資料還在,但這只證明 Pod 層的重啟,正式 DB 先不搬。
- 零中斷不是預設值。blog 是 2 / 240,比較可能的原因是沒有 preStop(事後推論,未驗證);app-b 靠 2 副本、
maxUnavailable: 0、preStop、會檢查 DB 與 cache 的 readiness 一起成立,做到 0 / 241。
系列文章:從 docker compose 到 k3s
- 第 1 篇:【k8s】把 docker compose 上的 Laravel 搬上 Kubernetes(上):image、架構與零中斷滾動更新(本篇)
- 第 2 篇:【k8s】把 docker compose 上的 Laravel 搬上 Kubernetes(下):Helm chart、queue worker 與 CronJob
- 第 3 篇:在 ARM VM 上用 k3s 部署同一個 chart(準備中)
延伸閱讀:「自架 VM 維運實戰」系列,從第 1 篇【資安】Cloudflare Access 實戰:不用 VPN 保護後台與 Grafana開始,最後一篇是【AI】讓 AI 安全查 Grafana:自架官方 mcp-grafana 的五層防護。
No comments yet.